PMPP Chapter 06: Performance considerations
本章主要内容
- present the off-chip memory (DRAM) architecture and discuss related performance considerations such as memory coalescing and memory latency hiding.
- discuss an important type of optimization—thread granularity coarsening.
- wrap up this part of the book with a checklist of common performance optimizations that will serve as a guide for optimizing the performance of the parallel patterns that will be discussed in the second and third parts of the book.
性能调优的核心原则
- 不同应用中,不同的架构约束可能成为性能瓶颈。
- 常用手段:用一种资源使用换取另一种资源使用(trade one resource usage for another)。
- 这种策略有效的条件:
- 被缓解的资源约束原本是主导瓶颈;
- 被加剧的资源约束不会对并行执行产生负面影响。
- 优化前先定位主导瓶颈,再选择针对性的资源权衡策略。
1. Memory coalescing
global memory (DRAM) 特性
- DRAM 存储原理:
- 数据位存储在微小电容中,通过电荷的有无区分 1 和 0。
- 读取时,电容需用微弱电荷驱动高电容线路到传感器,由传感器判断是否为 “1”。
- 这一过程在现代 DRAM 中需要数十纳秒。
- 与计算速度的对比:
- 现代计算设备的时钟周期在亚纳秒级别。
- DRAM 访问速度远慢于 CPU/GPU 的计算速度。
- 应对方式:
- 现代 DRAM 设计使用并行访问来提高数据访问速率。
- 同样是牺牲 latency 换 throughput
- 这种并行带来的速率通常称为 memory access throughput(内存访问吞吐量)。
- 现代 DRAM 设计使用并行访问来提高数据访问速率。
- DRAM Burst(突发传输):
- 每次访问 DRAM 时,并非只读取请求的单个位置,而是读取包含该位置的一连串连续位置。
- 每个 DRAM 芯片中有多个传感器,并行感测这些连续位置中的各个 bit。
- 感测完成后,整段连续数据可高速传输到处理器。
- 这段被访问并传输的连续位置称为 DRAM burst。
- 优化启示:
- 如果程序能集中使用 burst 内的数据(即访问具有良好的空间局部性),DRAM 的有效带宽会远高于随机访问。
- 这正是 memory coalescing(内存合并) 的物理基础:让相邻线程访问相邻地址,以充分利用 DRAM burst。
Memory Coalescing(内存合并)
- CUDA 的合并访问机制:
- 利用 warp 内线程在任意时刻执行同一条指令的特点。
- 当 warp 所有线程执行同一条 load 指令时,硬件检测它们是否访问连续的全局内存地址。
- 若连续,硬件将这些访问合并为一次对连续 DRAM 位置的请求(coalesced access)。
- DRAM 随后以 burst 方式高效传输数据。
- 最有利的访问模式:
- warp 内线程 i 访问地址
X + i(i = 0, 1, 2, ...),即相邻线程访问相邻地址。 - 此时一次 warp 的 load 可合并为一个或少数几个 DRAM burst,带宽利用率最高。
- warp 内线程 i 访问地址
- 反例(非合并访问):
- 若相邻线程访问的地址跨度过大(如步长 > 1),则无法合并,需要多次 DRAM 事务,有效带宽大幅下降。
- 优化启示:
- 编写 kernel
时,应尽量让相邻线程访问相邻内存地址(如按行访问二维数组时,用
threadIdx.x映射到连续列)。 - 合并访问是发挥 DRAM 高吞吐量的关键。
- 编写 kernel
时,应尽量让相邻线程访问相邻内存地址(如按行访问二维数组时,用
合并访问示例:
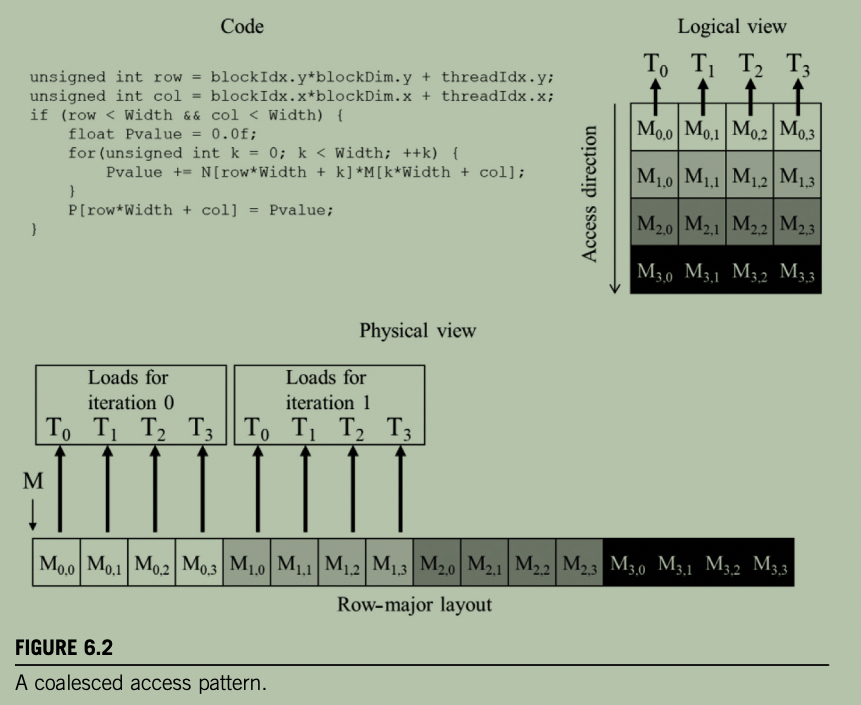
- 假设一个多维数组作为矩阵乘法的第二个输入矩阵(矩阵 M)。
- 注意命名不一致:
- 本节代码中
M和N的角色与通常约定相反:- 代码中的
N[row * Width + k]是左矩阵(\(m \times k\))。 - 代码中的
M[k * Width + col]是右矩阵(\(k \times n\)),即正文所说的“第二个输入矩阵”。
- 代码中的
- Warp 中连续线程负责连续输出元素时,会遍历该输入矩阵的连续列。
- 代码中访问 M 的索引: \[
\text{index} = k \times \text{Width} + \text{col}
\]
k和Width在整个 warp 内相同。col = blockIdx.x * blockDim.x + threadIdx.x。
- 因此:
- 连续线程(
threadIdx.x连续)→col连续 → 访问 M 的连续元素。
- 连续线程(
- 结果:满足合并访问条件,硬件可将这些访问合并为少量 DRAM burst。
- 结论:这种访问模式对全局内存友好,能实现高带宽利用率。
如果上述矩阵变成 column-major(非合并访问):
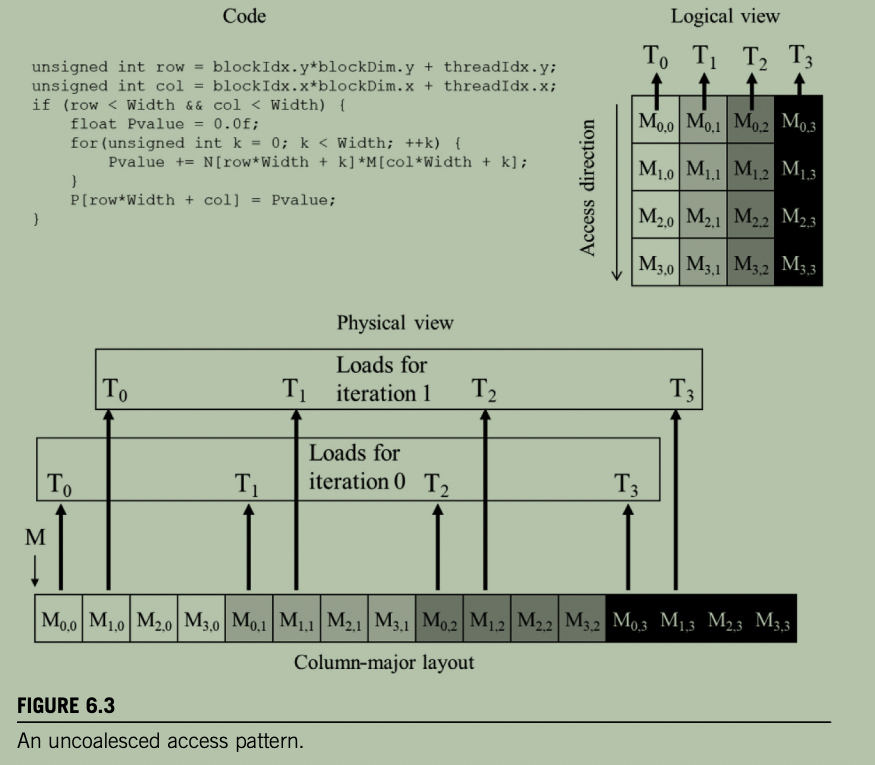
- 场景:矩阵以列主序存储,代码试图让连续线程访问连续列。
- 代码索引:
M[col * Width + k]col连续(由threadIdx.x决定),但乘以Width。k是内层循环变量,warp 内相同。
- 地址模式:
- 线程 0:
k - 线程 1:
Width + k - 线程 2:
2 * Width + k - 相邻线程地址间隔
Width,不连续。
- 线程 0:
- 结果:无法合并为一次 DRAM burst,需要多次内存事务,带宽利用率低。
- 对比行主序:
- 行主序索引
M[k * Width + col]→ 相邻线程地址连续 → 可合并。
- 行主序索引
- 启示:
- 合并访问不仅取决于线程映射,还取决于数据在内存中的布局。
- 若数据布局固定,可通过改变线程映射(如让线程沿行方向连续)或转置数据来改善。
实现内存合并访问的策略:
- 策略一:重新排列线程到数据的映射
- 改变线程索引方式,使相邻线程访问相邻地址。
- 例如,让线程沿行方向连续映射,而非列方向。
- 策略二:重新排列数据布局
- 将列主序矩阵转置为行主序,使其天然适合合并访问。
- 代价:转置本身需要额外开销。
- 策略三:借助 shared memory 中转(Corner Turning)
- 以合并方式将 global memory 数据加载到 shared memory。
- 在 shared memory 中执行原本不利的访问模式。
- 共享内存无合并要求,且延迟低,因此高效。
- Corner Turning 示例:
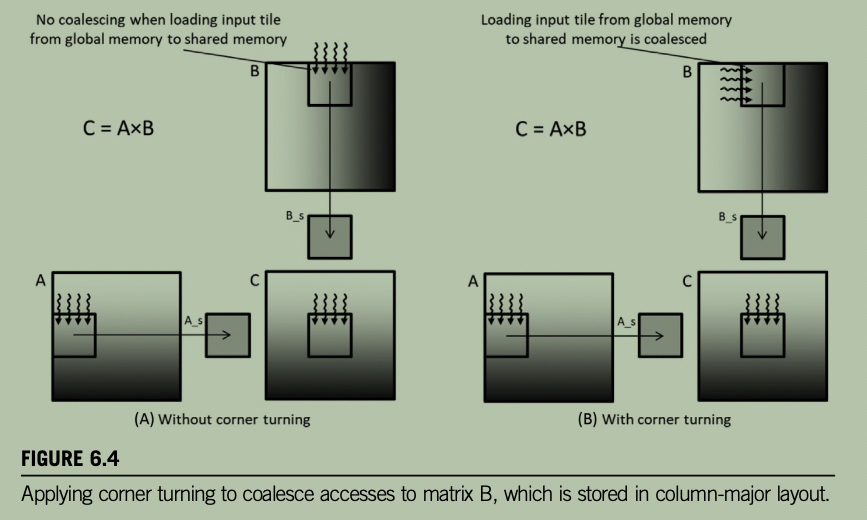
- A:行主序,B:列主序,C:行主序。
- 矩阵 A 的访问(对比基准):
- 与第 5 章相同:每个线程加载 A 的 tile 中,与自身输出元素局部坐标相同的元素。
- 连续线程访问 A 的同一行相邻元素。由于 A 是行主序,这些元素在内存中连续 → 合并访问(coalesced)。
- 矩阵 B 的访问(原始问题):
- 若沿用第 5 章的加载方式,四个线程逻辑上加载 B 的 tile 的顶边连续元素。
- 但由于 B 是列主序,同一行的元素在内存中相隔很远。连续线程访问的地址跨步巨大 → 非合并访问(uncoalesced)。
- 解决策略(Corner Turning):
- 让四个连续线程加载 B 的 tile 的**左边(同一列)的连续元素(图 6.4 B)。
- 直观操作:在计算 B 的加载线性索引时,交换
threadIdx.x和threadIdx.y的角色。 - 原理:B 是列主序,同一列的连续元素在内存中相邻。交换索引后,连续线程加载相邻地址 → 合并访问。
- 存入 Shared Memory 的灵活性:
- 将 B 的 tile 加载到 shared memory 时,可以按列主序存,也可以按行主序存。
- 加载完毕后,每个线程在 shared memory 中按计算需求访问元素(例如按行读取),几乎没有性能损失。
- 原因:shared memory 由 SRAM 构成,不需要合并访问(no coalescing required),且延迟远低于 global memory。
- 本质总结:
- 在 global memory 侧:通过交换线程映射,确保 B 的加载也是合并的。
- 在 shared memory 侧:完成不利的访问模式(按行读取列主序数据),因为 SRAM 不需要合并。
- 一句话:把不利的访问模式“搬到”更快、更灵活的内存层级(shared memory)去执行。
- 核心思想:
- 把不利的访问模式“搬到”更快、更灵活的内存层级(shared memory)去执行。
- 这是全书反复出现的优化思路之一。
Corner Turning 示例代码:
1 | |
- 补充:B 加载时的下标顺序与 Bank Conflict
- 如果加载 B 时写成
Bds[tx][ty],那么计算时确实不需要交换下标,直接用Bds[kk][tx]即可,逻辑正确。 - 但不推荐,因为它会把 Bank Conflict
转移到加载阶段:
Bds[tx][ty]的线性地址为tx * TILE_WIDTH + ty,连续线程(tx 连续)访问的地址跨步TILE_WIDTH,容易产生多路 Bank Conflict。
- 当前写法(推荐):
- 加载:
Bds[ty][tx],地址连续,无冲突。 - 计算:
Bds[tx][kk],在TILE_WIDTH = 16时,warp 内 32 个线程访问 16 个地址,每个地址被 2 个线程访问,属于广播(broadcast),无 Bank Conflict。
- 加载:
- 若
TILE_WIDTH = 32:- 计算时
Bds[tx][kk]会产生 32-way Bank Conflict。 - 解决方案:给共享内存数组加 padding,声明为
__shared__ float Bds[TILE_WIDTH][TILE_WIDTH + 1];,从而打破地址对齐,消除冲突。
- 计算时
- 结论:保持当前写法
Bds[ty][tx]+ 计算用Bds[tx][kk],在 TILE_WIDTH=16 时无 Bank Conflict;若 TILE_WIDTH=32,则需配合 padding。
- 如果加载 B 时写成
2. Hiding memory latency
DRAM 的并行组织结构
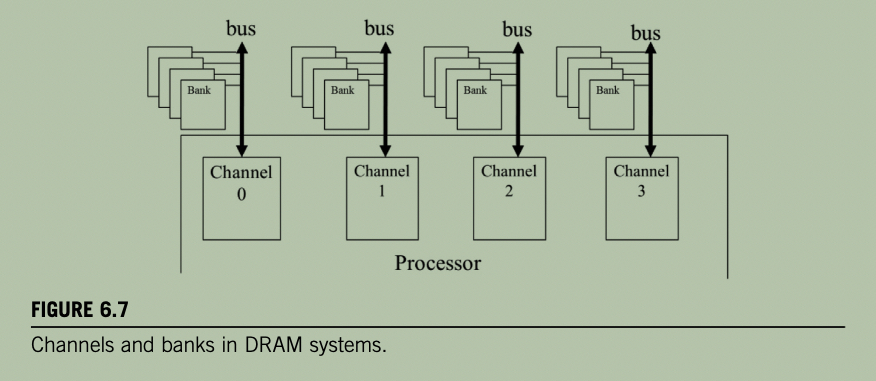
- Burst(突发传输):一次访问连续位置,传感器并行工作,高速传输连续数据。
- Channel(通道):内存控制器 + 总线,连接一组 DRAM banks 到处理器。现代 CPU 通常 2 通道,GPU 需要 16 通道。
- Bank(存储体):每个通道连接多个 bank,每个 bank 包含 DRAM 单元阵列、感测放大器和接口。
- 目标:通过多级并行(burst、bank、channel)满足现代处理器的带宽需求。
为什么需要多个 Bank?
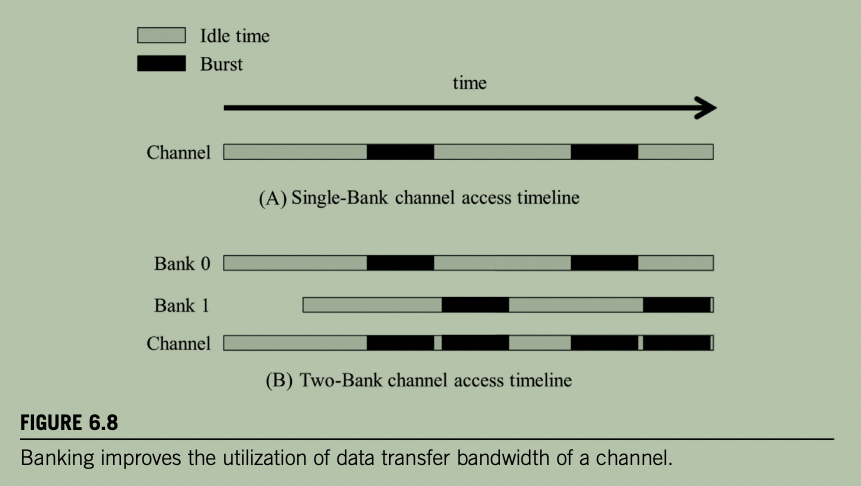
- 单 bank 问题:
- 访问延迟(灰色)远长于数据传输时间(黑色),例如延迟:传输 = \(20:1\)。
- 单 bank 总线利用率仅为 \(1/21 \approx 4.8\%\)(如 \(16\) GB/s 通道实际仅 \(0.76\) GB/s),不可接受。
- 多 bank 解决:
- 当一个 bank 在等待长延迟时,另一个 bank 可以开始访问,重叠延迟。
- 若延迟:传输 = \(R\),则需要至少 \(R+1\) 个 bank 才能完全利用带宽。
- 实际需要更多 bank,原因:
- 降低 Bank Conflict(多个访问同时命中同一 bank)的概率。
- 每个 bank 容量有限,需要多个 bank 才能满足总内存容量需求。
交错数据分布(Interleaved Data Distribution)
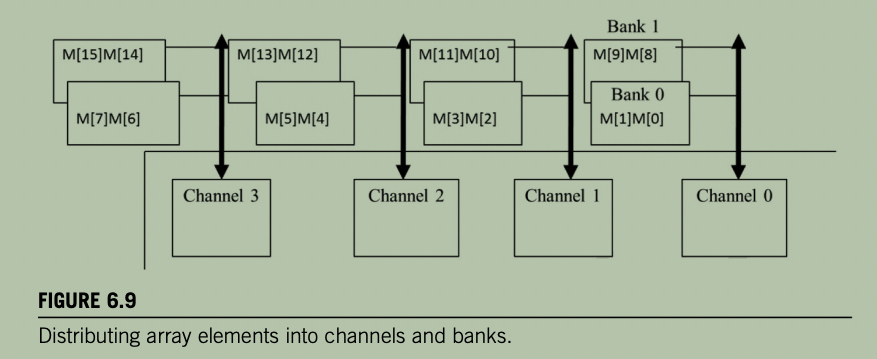
- 策略:将连续内存元素分散到不同 channel 和 bank。
- 例(burst = 2 元素/8B):
M[0:1]→ Channel 0, Bank 0M[2:3]→ Channel 1, Bank 0M[4:5]→ Channel 2, Bank 0M[6:7]→ Channel 3, Bank 0M[8:9]→ Channel 0, Bank 1(绕回并切换 bank)
- 例(burst = 2 元素/8B):
- 好处:即使较小的数组也能均匀分布在所有 channel 和 bank 上,最大化并行访问。
- 硬件决定:地址到 channel/bank 的映射由硬件设计完成。
线程并行性与内存并行性的交互
- 前提:要获得标称带宽,必须有足够多的线程同时发出内存访问请求——这与最大化 occupancy 直接相关。
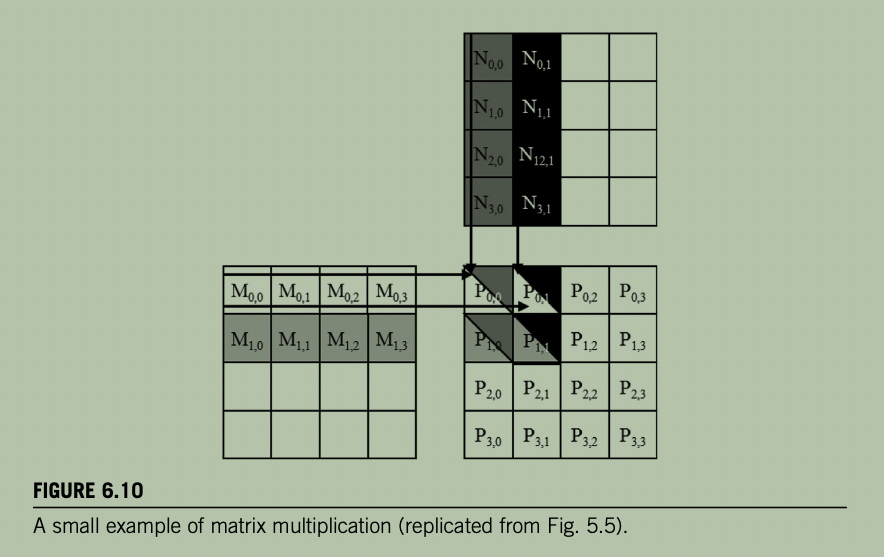
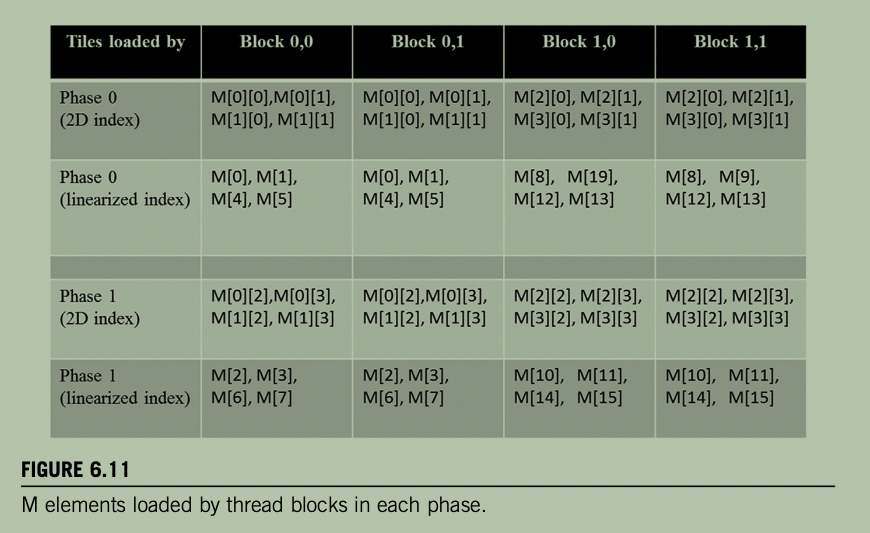
- 示例:\(2 \times
2\) 线程块,\(2 \times 2\)
tile,矩阵 \(4 \times 4\)。
- Phase 0:4 个 block 加载首个 tile。
- Block 0,0 和 Block 0,1 加载相同的 M 元素 → 缓存可合并访问。
- 合并访问分布在 Channel 0 和 Channel 2 的 bank 上 → 并行执行。
- Phase 1:访问分布在 Channel 1 和 Channel 3。
- 结果:所有 4 个通道都被利用。
- Phase 0:4 个 block 加载首个 tile。
- 共生关系:
- 好的 DRAM 带宽利用 → 需要大量线程同时访问。
- 设备执行吞吐 → 依赖 DRAM 并行结构(bank / channel)的良好利用。
- 若所有线程访问同一 channel → 吞吐严重下降。
关键结论
- 隐藏 DRAM 延迟不仅依赖 burst,还需要 bank 和 channel 的并行。
- 最大化 occupancy 不仅隐藏核心流水线延迟,还隐藏 DRAM 访问延迟。
- 理想情况:
- 足够多的并发内存请求(高 occupancy)。
- 请求均匀分布在 channel 和 bank 上。
- 每次访问都是 coalesced access。
- 更大矩阵(如 \(8 \times 8\))可充分利用所有 4 个通道;更大的 burst size 需要更大的矩阵才能充分利用带宽。
向量化访存与 128B 内存事务(Vectorized Memory Access & 128B)
- 128B 的来源:
- 现代 NVIDIA GPU(从 Volta 到 Ampere/Hopper)中,L2 缓存与 DRAM 之间的典型内存事务大小(或缓存行大小)为 128 字节。
- 一个 warp 有 32 个线程。如果每个线程访问 4 字节(
float或int),则一个 warp 的总访问量为: \[ 32 \times 4 \text{ B} = 128 \text{ B} \] - 因此,一个 warp 的合并访存在最理想情况下正好产生一个 128B 的内存事务。
- 向量化访存的含义:
- 使用更宽的数据类型(如
float4、int4、double2),让每个线程一次加载 16 字节(float4)而不是 4 字节。 - 例:
1
float4 val = reinterpret_cast<float4*>(A)[index]; - 此时一个 warp 的总访问量为: \[ 32 \times 16 \text{ B} = 512 \text{ B} = 4 \times 128 \text{ B} \]
- 硬件会将其拆分为 4 个 128B 的内存事务,但通过一条指令即可发出,显著减少了指令开销。
- 使用更宽的数据类型(如
- 与合并访存(Coalescing)的关系:
- 合并访存关注的是:warp 内相邻线程是否访问相邻地址,从而将多个小访问合并为少量 128B 事务。
- 向量化访存关注的是:单个线程一次能搬运多少数据,从而用更少的指令填满这些 128B 事务。
- 两者互补:合并访存解决了“地址是否连续”,向量化访存解决了“每次搬多少”。
- 最佳实践:相邻线程访问相邻地址(合并),且每个线程使用
float4(向量化),从而以最少的指令产生对齐的 128B 事务,达到峰值带宽。
- 对隐藏内存延迟的帮助:
- 向量化访存减少了每个线程所需的 load/store 指令数量。
- 指令数减少 → 发射周期减少 → SM 可以更快地发出更多并发内存请求。
- 这提高了 内存级并行性(Memory-Level Parallelism, MLP),从而更有效地隐藏 DRAM 的长延迟。
- 结合高 occupancy,SM 可以维持大量 in-flight 的内存请求,充分利用 channel 和 bank 的并行性。
- 对齐要求(Alignment):
- 向量化访存(如
float4)要求地址按 16 字节对齐。 - 若地址未对齐,会导致非法访问错误,或回退到多次窄访问,失去向量化优势。
- 编写 kernel 时,应确保:
- 数组起始地址按 16 字节对齐(如使用
cudaMalloc默认满足)。 - tile 或索引计算保证每个线程访问的偏移是 16 字节的整数倍。
- 数组起始地址按 16 字节对齐(如使用
- 向量化访存(如
- 与 DRAM Burst 和 Channel/Bank 的关系:
- DRAM burst 是物理层的连续传输单元,128B 内存事务是逻辑层的缓存行粒度。
- 向量化 + 合并访存使 warp 请求恰好对齐 128B 事务,从而:
- 减少指令发射负担。
- 如果一个 warp 标量加载 512B 需 4 条 load 指令;
float4加载只需 1 条。 - 释放的发射槽可留给计算指令,提升整体吞吐。
- 在 memory-bound kernel 中直接转化为更高有效带宽。
- 如果一个 warp 标量加载 512B 需 4 条 load 指令;
- 提高 burst 利用率。
- 使请求更均匀地分布在多个 channel 和 bank 上,减少 bank conflict。
- 最大化 DRAM 数据总线带宽。
- 减少指令发射负担。
- 一句话总结:
- 128B 是硬件内存事务的自然粒度;向量化访存 + 合并访存,就是用最少的指令、最连续的对齐地址,高效填满这 128B,从而最大化有效带宽并隐藏延迟。
3. Thread coarsening
核心概念与动机
- 细粒度并行(Fine-grained parallelism):目前所有 kernel 都采用最细粒度划分(如矩阵乘法中每个线程负责一个输出元素)。
- 细粒度并行的优势:增强透明可伸缩性(transparent scalability)。硬件有资源则并行,资源不足则自动串行化 block。
- 细粒度并行的劣势:当并行化存在“代价”(price)时,会产生额外开销,例如:
- 不同 block 间冗余的数据加载
- 冗余计算
- 同步开销
- 粗化的核心思想:当硬件资源不足、可能被迫串行执行时,与其白白支付并行的代价,不如让程序员主动部分串行化,即给每个线程分配多个工作单元,以减少并行开销。这称为 Thread Coarsening(线程粗化)。
在矩阵乘法中的应用
- 问题:计算水平相邻的两个输出 tile 时,需要不同的 N tile,但需要相同的 M tile。原实现中每个输出 tile 由不同 block 处理,共享内存无法跨 block 共享,导致 M tile 被冗余加载。
- 解决:让一个 block 处理多个输出 tile,每个线程负责多个输出元素。这样 M tile 只需加载一次,就可复用于多个输出 tile。
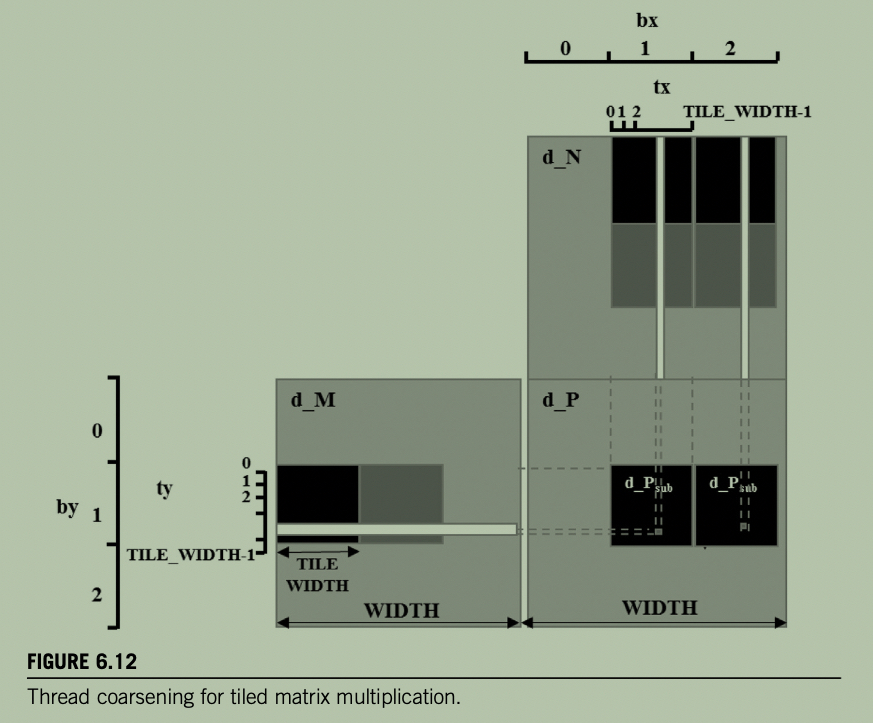
tile 矩阵乘法 thread coarsening 版本
1 | |
Thread coarsening 版本 Global Memory Access 分析(对比朴素 tiled 版本)
- 朴素 tiled 版本的 global memory 访问量:
- 对于 \(m \times k\) 的 M 和 \(k \times n\) 的 N,输出 \(m \times n\) 的 P。
- 每个 block 计算一个 \(TILE\_WIDTH \times TILE\_WIDTH\) 的输出 tile。
- M 的元素会被列方向所有 block 重复加载: \[ \text{每个 M 元素加载次数} = \frac{n}{TILE\_WIDTH} \]
- N 的元素会被行方向所有 block 重复加载: \[ \text{每个 N 元素加载次数} = \frac{m}{TILE\_WIDTH} \]
- 总加载元素次数: \[ m \cdot k \cdot \frac{n}{TILE\_WIDTH} + k \cdot n \cdot \frac{m}{TILE\_WIDTH} = 2 \cdot \frac{m \cdot k \cdot n}{TILE\_WIDTH} \]
- 以字节计(
float为 4B): \[ \text{Bytes} = 8 \cdot \frac{m \cdot k \cdot n}{TILE\_WIDTH} \]
- Thread Coarsening 版本的 global memory 访问量:
- 每个 block 在列方向覆盖 \(TILE\_WIDTH \times COARSE\_FACTOR\) 个输出元素。
- 列方向 block 数变为: \[ \frac{n}{TILE\_WIDTH \cdot COARSE\_FACTOR} \]
- 行方向 block 数不变: \[ \frac{m}{TILE\_WIDTH} \]
- 因此:
- M 元素的加载次数降为: \[ \frac{n}{TILE\_WIDTH \cdot COARSE\_FACTOR} \]
- N 元素的加载次数保持不变:
- 总加载元素次数: \[ m \cdot k \cdot \frac{n}{TILE\_WIDTH \cdot COARSE\_FACTOR} + k \cdot n \cdot \frac{m}{TILE\_WIDTH} = \frac{m \cdot k \cdot n}{TILE\_WIDTH} \cdot \left(1 + \frac{1}{COARSE\_FACTOR}\right) \]
- 节省比例(与 COARSE_FACTOR 的关系):
- 朴素 tiled 总访问量记为: \[ A_{\text{tiled}} = 2 \cdot \frac{m \cdot k \cdot n}{TILE\_WIDTH} \]
- Coarsening 后总访问量: \[ A_{\text{coarsen}} = \frac{m \cdot k \cdot n}{TILE\_WIDTH} \cdot \left(1 + \frac{1}{COARSE\_FACTOR}\right) \]
- 减少的比例: \[ \frac{A_{\text{tiled}} - A_{\text{coarsen}}}{A_{\text{tiled}}} = \frac{2 - \left(1 + \frac{1}{COARSE\_FACTOR}\right)}{2} = \frac{1 - \frac{1}{COARSE\_FACTOR}}{2} \]
- 即: \[ \text{节省比例} = \frac{1}{2} \left(1 - \frac{1}{COARSE\_FACTOR}\right) \]
- 具体数值:
- \(COARSE\_FACTOR = 1\)(无粗化):节省比例 = \(0\)。
- \(COARSE\_FACTOR = 2\):节省比例 = \(\frac{1}{2}(1 - 1/2) = 25\%\)。
- \(COARSE\_FACTOR = 4\):节省比例 = \(\frac{1}{2}(1 - 1/4) = 37.5\%\)。
- \(COARSE\_FACTOR = 8\):节省比例 = \(\frac{1}{2}(1 - 1/8) = 43.75\%\)。
- \(COARSE\_FACTOR \to \infty\):节省比例趋近于 \(50\%\)。
- 为什么只能节省最多 50%?
- Coarsening 只消除了 M 的冗余加载(列方向合并),但 N 的冗余加载仍然存在(行方向 block 数不变)。
- 若要同时减少 N 的冗余,需要对行方向也做 coarsening(二维粗化),但那会进一步增加每线程的寄存器压力(需要保存更多输出累加器),可能降低 occupancy。
- 算术强度提升:
- 计算量固定为 \(2 \cdot m \cdot n \cdot k\) FLOP。
- 朴素 tiled 算术强度: \[ \frac{2 \cdot m \cdot n \cdot k}{8 \cdot m \cdot k \cdot n / TILE\_WIDTH} = \frac{TILE\_WIDTH}{4} \ \text{FLOP/B} \]
- Coarsening 后算术强度: \[ \frac{2 \cdot m \cdot n \cdot k}{4 \cdot \frac{m \cdot k \cdot n}{TILE\_WIDTH} \left(1 + \frac{1}{COARSE\_FACTOR}\right)} = \frac{TILE\_WIDTH}{2 \left(1 + \frac{1}{COARSE\_FACTOR}\right)} \ \text{FLOP/B} \]
- 当 \(TILE\_WIDTH = 32\),\(COARSE\_FACTOR = 4\):
- 朴素:\(32/4 = 8\) FLOP/B。
- Coarsening 后:\(32 / (2 \times 1.25) = 12.8\) FLOP/B,提升 60%。
- 结论:
- Thread coarsening 通过让一个 block 复用 M tile,将 M 的 global memory 加载次数减少为原来的 \(1/COARSE\_FACTOR\)。
- 总 global memory 访问量减少比例仅取决于 \(COARSE\_FACTOR\),上限为 50%。
- 该优化提高了算术强度,使 kernel 更不容易受限于内存带宽,但需注意寄存器使用量增加可能影响 occupancy。
线程粗化的三个陷阱(Pitfalls)
- 在不需要时应用:
- 若计算本身没有并行代价(如向量加法、RGB 转灰度),粗化不会带来显著性能提升。
- 过度粗化导致硬件资源闲置:
- 粗化会减少暴露给硬件的并行度。若粗化因子过高,并行度不足,部分执行资源会闲置。
- 最佳粗化因子通常依设备与数据集而定,导致可伸缩性变得不再透明,需要针对不同设备重新调优。
- 资源消耗过高导致占用率下降:
- 粗化可能增加每线程的寄存器使用量或每 block 的共享内存使用量。
- 若导致 occupancy 下降,其性能损失可能超过粗化带来的收益。
4. A checklist of optimizations
CUDA kernel 性能优化 checklist 表格:
| Optimization | Benefit to compute cores | Benefit to memory | Strategies |
|---|---|---|---|
| Maximizing occupancy | More work to hide pipeline latency | More parallel memory accesses to hide DRAM latency | Tuning usage of SM resources such as threads per block, shared memory per block, and registers per thread |
| Enabling coalesced global memory accesses | Fewer pipeline stalls waiting for global memory accesses | Less global memory traffic and better utilization of bursts/cache lines | Transfer between global memory and shared memory in a coalesced manner and performing uncoalesced accesses in shared memory (e.g., corner turning). Rearranging the mapping of threads to data. Rearranging the layout of the data. |
| Minimizing control divergence | High SIMD efficiency (fewer idle cores during SIMD execution) | - | Rearranging the mapping of threads to work and/or data. Rearranging the layout of the data. |
| Tiling of reused data | Fewer pipeline stalls waiting for global memory accesses | Less global memory traffic | Placing data that is reused within a block in shared memory or registers so that it is transferred between global memory and the SM only once |
| Privatization (covered later) | Fewer pipeline stalls waiting for atomic updates | Less contention and serialization of atomic updates | Applying partial updates to a private copy of the data and then updating the universal copy when done |
| Thread coarsening | Less redundant work, divergence, or synchronization | Less redundant global memory traffic | Assigning multiple units of parallelism to each thread to reduce the price of parallelism when it is incurred unnecessarily |
- Maximizing occupancy
- 第 4 章:强调线程数远多于核心数,以隐藏核心流水线长延迟。
- 第 5 章:shared memory 也是需谨慎调优的资源,避免限制 occupancy。
- 第 6 章:高 occupancy 还能隐藏内存延迟,确保生成足够内存访问以充分利用带宽。
- 策略:调节每 block 线程数、每 block shared memory、每线程寄存器数。
- Enabling coalesced global memory accesses
- 本章:同一 warp 的线程访问相邻内存位置,硬件合并为少量内存请求,减少 global memory 流量,提高 DRAM burst 利用率。
- 本部分 kernel 天然合并;第二、三部分会有更多不规则访问。
- 策略:
- 通过 shared memory 中转:以合并方式加载到 shared memory,再在 shared memory 中执行不规则访问。例:corner turning;第 12 章 Merge(二分查找前先合并加载);第 13 章 Sorting(scatter 写回前先在 shared memory 中处理,再合并写回)。
- 重排线程到数据的映射:第 10 章 Reduction。
- 重排数据布局:第 14 章 Sparse Matrix(ELL / JDS 格式)。
- Minimizing control divergence
- 第 4 章:同一 warp 内线程走同一控制路径,保证 SIMD 执行时所有核心有效利用。
- 本部分除边界条件外基本无发散;第二、三部分中发散可能严重损害性能。
- 策略:
- 重排工作/数据在线程间的分布:让一个 warp 的线程先用完,再使用其他 warp;第 10 章 Reduction、第 11 章 Scan。
- 让同一 warp 内线程工作量相似:第 15 章 Graph Traversal(顶点中心 vs 边中心)。
- 重排数据布局:第 14 章 Sparse Matrix(JDS 格式)。
- Tiling of reused data
- 第 5 章:矩阵乘法中,同一输出 tile 的线程协作加载输入 tile 到 shared memory,并重复访问。
- 第二、三部分多数并行模式都会再次应用。
- 挑战:输入和输出 tile 维度不同时如何 tiling。第 7 章 Convolution、第 8 章 Stencil。
- 扩展:tile 数据也可存于寄存器,而非仅 shared memory(第 8 章 Stencil)。
- 扩展:tiling 也适用于被重复访问的输出数据,而不仅是输入数据。
- Privatization
- 本章尚未展开,为完整性列出。
- 场景:多个线程或 block 需要更新同一个全局输出。
- 策略:创建私有副本,先部分更新,最后再合并回全局副本。
- 应用:第 9 章 Parallel Histogram(多个线程更新同一组直方图计数器);第 15 章 Graph Traversal(多个线程向同一队列添加条目)。
- Thread coarsening
- 本章:tiled 矩阵乘法中,相邻输出 tile 的多个 block 会冗余加载同一 M tile。让一个 block 处理多个相邻输出 tile,每个线程负责多个输出元素,M tile 只需加载一次。
- 后续应用:
- 第 8 章 Stencil:减少冗余输入加载。
- 第 9 章 Parallel Histogram:减少需要提交到全局副本的私有副本数量。
- 第 10 章 Reduction、第 11 章 Scan:减少同步和控制发散开销。
- 第 11 章 Scan:减少并行算法相对串行算法的冗余工作。
- 第 12 章 Merge:减少确定每个线程输入段所需的二分查找次数。
- 第 13 章 Sorting:改善内存合并。
其他章节特定优化
- 第 7 章 Convolution:引入 constant memory。
- 第 10 章 Reduction / Scan:引入 double-buffering。
总结:该 checklist 并非穷尽,但涵盖跨不同计算模式的通用优化。第二、三部分会反复应用这些优化,并引入特定场景下的额外优化。
5. Knowing your computation's bottleneck
- 性能瓶颈(bottleneck):限制计算性能的资源。
- 优化的本质:通常是用更多的一种资源去减轻另一种资源的负担。
- 若优化没有针对瓶颈资源,可能毫无收益,甚至适得其反。
- 示例:
- shared memory tiling 增加 shared memory 使用,以减轻 global memory 带宽压力。
- 当瓶颈是 global memory 带宽且数据可复用时,该优化效果很好。
- 但若瓶颈是 occupancy,且 occupancy 已经因 shared memory 使用过多而受限,则 tiling 会进一步降低 occupancy,使性能更差。
- 如何定位瓶颈:
- 使用 GPU 计算平台提供的 profiling 工具(nsys/ncu)。
- 瓶颈可能因硬件而异:同一计算在不同设备上可能遇到不同瓶颈。
- 实践要求:
- 识别瓶颈并应用优化,需要深入理解 GPU 架构以及不同 GPU 设备之间的架构差异。
- 优化前先问:当前限制性能的资源是什么?优化是否针对该资源?
6. Summary
- 本章内容:
- GPU off-chip memory (DRAM) 架构及相关性能考量。
- Global memory access coalescing(全局内存合并访问)。
- 利用内存并行隐藏内存延迟(hiding memory latency with memory parallelism)。
- 重要优化:Thread granularity coarsening(线程粒度粗化)。
- 能力目标:结合本章与前几章的洞察,读者应能推理任意 kernel 代码的性能。
- 本部分收尾:给出常用性能优化 checklist,广泛用于优化各类计算。
- 后续展望:第二、三部分将研究这些优化在并行计算模式和应用案例中的实际应用。
7. PMPP 4/5/6 三章回顾
核心回顾主线:从硬件执行模型到性能优化
第 4 章:执行模型(GPU 为什么这么快?)
- 核心逻辑:SM → Block → Warp → Thread 的映射。
- 关键机制:SIMT 执行、分支发散(Control Divergence)、零开销调度(Zero-overhead Scheduling)。
- 核心概念:Occupancy(占用率)——用大量线程隐藏延迟。
- 回顾问题:
- 为什么同一 warp 内线程走不同分支会变慢?
- 为什么 GPU 不需要 CPU 那种大 Cache 和分支预测?
- 哪些资源限制了 Occupancy?
第 5 章:内存层级(如何把数据搬得更快?)
- 核心逻辑:Global Memory(大但慢)→ Shared Memory(小但快)→ Register(极快但极小)。
- 核心优化:Tiling(分块)——让数据在 Shared Memory 中复用,减少 Global Memory 访问。
- 关键细节:边界检查(三套独立检查)、Corner Turning(解决列主序不合并)、动态 Shared Memory。
- 回顾问题:
- Tiling 把算术强度从 0.25 提升到了多少?
- 为什么加载 M 和 N 的边界检查不能共用?
- Corner Turning 到底“转”了什么角?
第 6 章:性能优化(如何知道哪里是瓶颈?)
- 核心逻辑:内存合并(Coalescing)→ 隐藏延迟(Bank/Channel 并行)→ 线程粗化(Thread Coarsening)。
- 核心工具:Roofline Model(判断 memory-bound 还是 compute-bound)。
- 核心清单:Table 6.1 的 6 大优化(Occupancy、Coalescing、Divergence、Tiling、Privatization、Coarsening)。
- 回顾问题:
- 128B 内存事务和 warp 合并访问是什么关系?
- 为什么线程粗化最多只能节省 50% 的 global memory 访问?
- 什么时候不该用 Thread Coarsening?
PMPP Chapter 06: Performance considerations
https://arcsin2.cloud/posts/2026/09/2846274018/