PMPP Chapter 03: Multidimensional grids and data

多维 grid & block

  • gridDim
    • gridDim.x 范围:[1, 2^{31} -1]
    • gridDim.y & gridDim.z 范围:[1, 2^{16} -1]
  • blockDim
    • 最多 1024 线程(blockDim.x blockDim.y blockDim.z <= 1024)
  • blockIdx
  • threadIdx

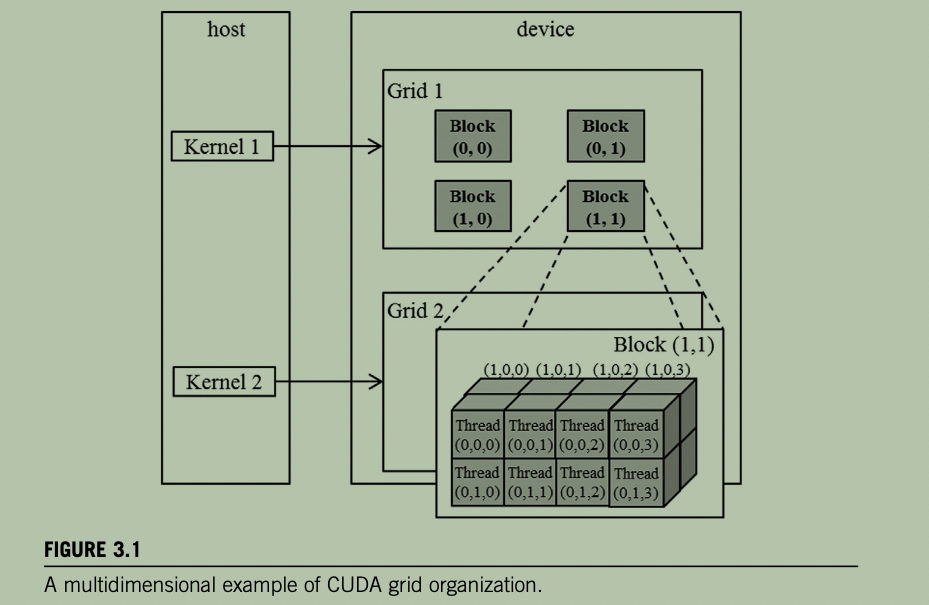
Example:


  • 图中坐标规则是 (z, y, x) (最高维在前),与 C 语言中设置 dim3 的 (x, y, z) 顺序相反。
    • 例:block (1, 0) 表示 blockIdx.y = 1, blockIdx.x = 0
    • 线程同理:thread (1, 0, 2) 表示 threadIdx.z = 1, threadIdx.y = 0, threadIdx.x = 2
  • 本书后续约定
    • 多维数据维度按降序称呼:z 维 → y 维 → x 维。
      • 例如:一幅在 y (列)方向有 n 个像素、x (行)方向有 m 个像素的图片,称为 n m 图片。
    • 遵循 C 语言多维数组索引约定:P[y][x] 在文本和图中简写为 P_{y,x}。
    • 注意:这种数据维度顺序与 gridDim / blockDim 中 (x, y, z) 的顺序相反。在根据待处理的多维数组来定义线程网格维度时,尤其容易混淆。
  • 示例配置
    • Grid:4 个 block,gridDim = (2, 2)(x * y),无 z 维度。
    • Block:每个 block 16 个线程,blockDim = (4, 2, 2)(x y z)。
    • 总线程数:4 = 64。

Mapping threads to multidimensional data

gridDim & blockDim 通常根据要处理的数据维度来定。以二维图像为例,使用 2D grid & 2D block:
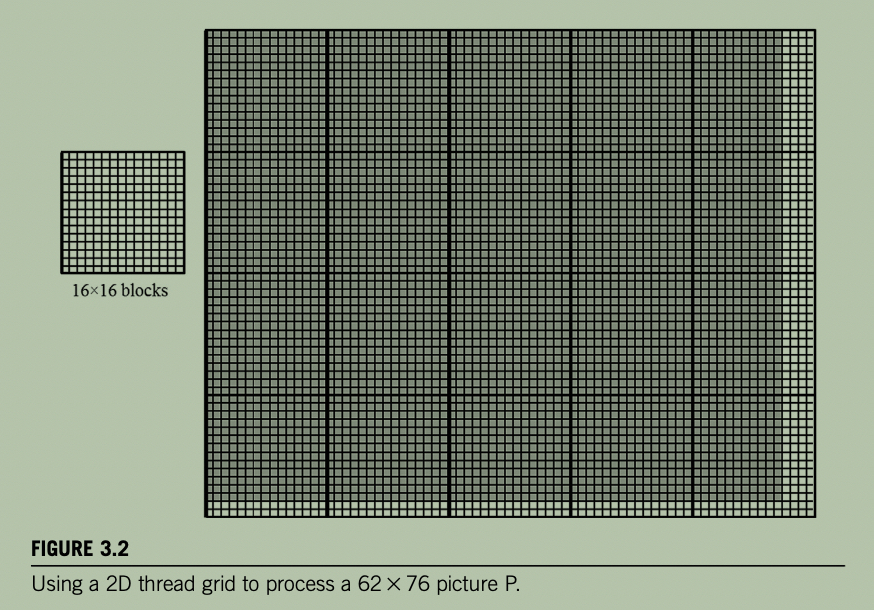

  • 图片 shape 为 (62, 76)
    • 竖直(y)方向 62 (记做 n=62) 个像素
    • 水平(x)方向 76 (记做 m=76)个像素
  • blockDim: (16, 16)
    • y 方向需要 (62 + 16 - 1)/16 = 4 个 blocks
    • x 方向需要 (76 + 16 - 1)/16 = 5 个 blocks
  • thread 负责的数据坐标计算
    • 竖直(行)坐标:blockIdx.y * blockDim.y + threadIdx.y
    • 水平(列)坐标:blockIdx.x * blockDim.x + threadIdx.x
    • 例子:thread (0,0) of block (1,0) 处理的像素坐标计算
      • \(\mathbf{Pin}_{\text{blockIdx.y}*\text{blockDim.y}+\text{threadIdx.y},\text{blockIdx.x}*\text{blockDim.x}+\text{threadIdx.x}} = \mathbf{Pin}_{1*16+0,0*16+0} = \mathbf{Pin}_{16,0}\)
  • 根据 y/x 方向像素数量 n/m 计算 gridDim:
1
2
3
4
5
6
7
// 映射关系记忆:
// 输入数据方向顺序 (z, y, x),其中 x 方向变化最快(连续)
// dim3 初始化顺序为 (x, y, z),其中 x 方向 blockIdx.x/threadIdx.x 变化最快
// 变化最快的方向对应,则输入数据 x 方向的像素数量 m 用于初始化 dim3 的 x; y/n 类似。
dim3 dimGrid(ceil(m/16.0), ceil(n/16.0), 1);
dim3 dimBlock(16, 16, 1);
colorToGrayscaleConversion<<<dimGrid, dimBlock>>>(Pin_d, Pout_d, m, n);
  • 边界检查
1
2
3
4
5
6
// kernel 内必须进行边界检查,确保多余的 threads 不访问非法数据
int y = blockIdx.y * blockDim.y + threadIdx.y;
int x = blockIdx.x * blockDim.x + threadIdx.x;
if (y < n && x < m) {
// 处理 Pin[y][x]
}

colorToGrayscaleConversion kernel 完整代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
#define CHANNELS 3

__global__ void colorToGrayscaleConversion(unsigned char* Pout,
const unsigned char* Pin, int width, int height) {
int col = blockIdx.x * blockDim.x + threadIdx.x;
int row = blockIdx.y * blockDim.y + threadIdx.y;
if (col < width && row < height) {
int grayOffset = row * width + col;
int rgbOffset = grayOffset * CHANNELS;
unsigned char r = Pin[rgbOffset];
unsigned char g = Pin[rgbOffset + 1];
unsigned char b = Pin[rgbOffset + 2];
Pout[grayOffset] = 0.21f * r + 0.72f * g + 0.07f * b;
}
}

扩展到 3D 数据/block/grid,索引计算类似 2D:

1
2
3
4
5
int plane = blockIdx.z * blockDim.z + threadIdx.z;

int offset = plane * width * height + row * width + col;

// 有效索引检查需要同时考虑 plane/row/col

Image blur: a more complex kernel

图像模糊:输出像素由输入像素周围的若干个像素均值组成。

kernel 代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
#define BLUR_SIZE 1

__global__ void blurKernel(unsigned char* out,
const unsigned char* in, int width, int height) {
int col = blockIdx.x * blockDim.x + threadIdx.x;
int row = blockIdx.y * blockDim.y + threadIdx.y;

if (col < width && row < height) {
int pixVal = 0;
int pixels = 0;

for (int blurRow = -BLUR_SIZE; blurRow < BLUR_SIZE + 1; blurRow++) {
for (int blurCol = -BLUR_SIZE; blurCol < BLUR_SIZE + 1; blurCol++) {
int curRow = row + blurRow;
int curCol = col + blurCol;

if (curCol >= 0 && curCol < width && curRow >=0 && curRow < height) {
pixels++;
pixVal += in[curRow * width + curCol];
}
}
}

out[row * width + col] = (unsigned char)(pixVal / pixels);
}
}
  • Blur Kernel 要点
    • 每个线程负责一个输出像素 out[row * width + col]
    • 遍历 (2 * BLUR_SIZE + 1)^2 的邻域窗口。
    • 边界检查必须同时包括 >= 0< width/height,否则会越界访问。
    • pixels 统计有效邻居数量,保证边缘像素只对有效邻居求平均。

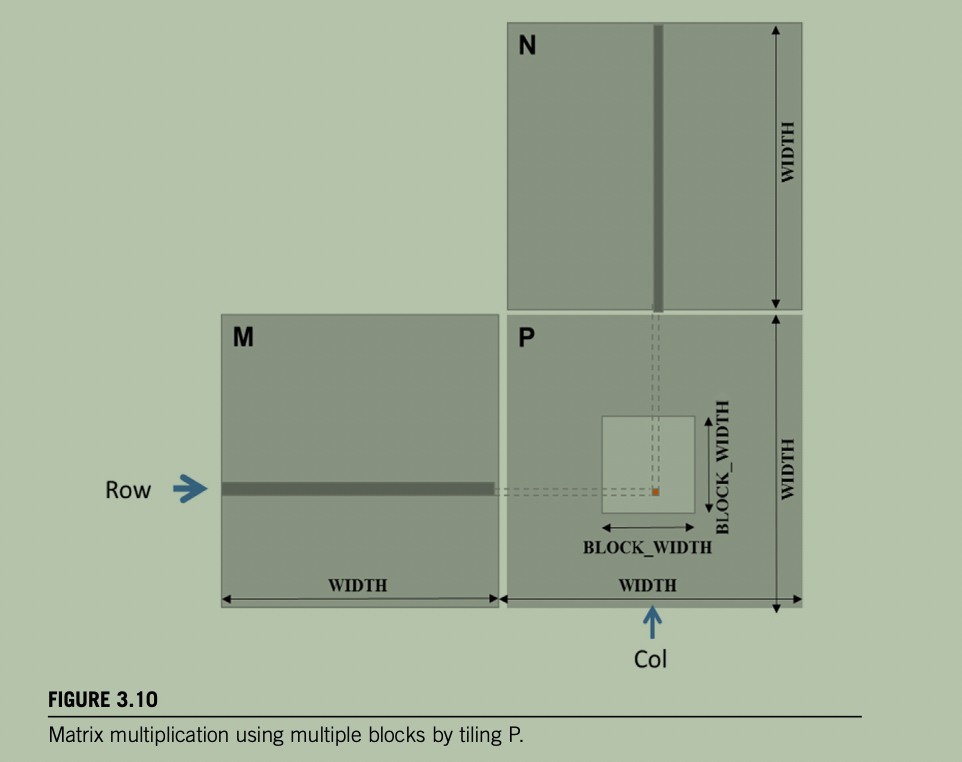
Matrix multiplication


每个线程计算一个输出结果版本 kernel

1
2
3
4
5
6
7
8
9
10
11
12
13
__global__ void MatrixMulKernel(float* M, float* N, float* P, int width) {
int col = blockIdx.x * blockDim.x + threadIdx.x;
int row = blockIdx.y * blockDim.y + threadIdx.y;

if (row < width && col < width) {
float sum = 0;
for (int k = 0; k < width; ++k) {
sum += M[row * width + k] * N[k * width + col];
}

P[row * width + col] = sum;
}
}
  • 同一线程的内存访问模式(M/N 都是 row-major)
    • 对 M 访问同一行多个列,连续访问
    • 对 N 跨行访问同一列,不连续

PMPP Chapter 03: Multidimensional grids and data
https://arcsin2.cloud/posts/2026/09/3085498718/
作者
arcsin2
发布于
2026年9月19日
许可协议