LLM Systems 19: LLM Quantization: Basic methods
0. Recap
之前课程主线:
- LLM 简介
- CUDA 编程基础
- 深度学习框架(自动求导)
- Transformer/Pre-trained LLM
- LLM 前后两个辅助组件:Tokenizer 与 Decoding
- Transformer 加速:Kernel Fusion & Mix-precision & Memory Management Optimization
- 支线(跳过):Guest Lecture:Google TPU/JAX 生态介绍
- 分布式训练技术:
- 基本概念与集合通信原语
- DDP
- TP
- PP
- MoE:限制 FLOPs 前提下提升模型参数效率 & EP 专家并行
- ZeRO:内存效率优化
接下来的 3 个 lecture(即:lecture 19 & 20 & 21)介绍模型量化与高效微调技术,即:通过将高精度数值转换为低比特格式,缩小模型体积并加速计算过程;使用低秩矩阵分解等技术,进行 LLM 参数高效的微调。
1. Low precision numbers in computer
1.1 Background
问题:LLM 训练推理成本高昂
- Llama-70B
- 39.3M H100-80GB GPU hours to train
- requires 140GB GPU memory for inference
- DeepSeek V3 (671GB)
- 2.8M H800 GPU hours to train
- requires > 400GB GPU memory for inference
Solution:模型量化
- 量化:使用低精度存储参数和层计算结果
- 优点:
- 减少内存占用 -> 更大 batch size
- 加速计算,每个时钟周期更多运算
- 缺点:
- 可能降低精度
- 优点:
1.2 Precision Formats
Precision Formats
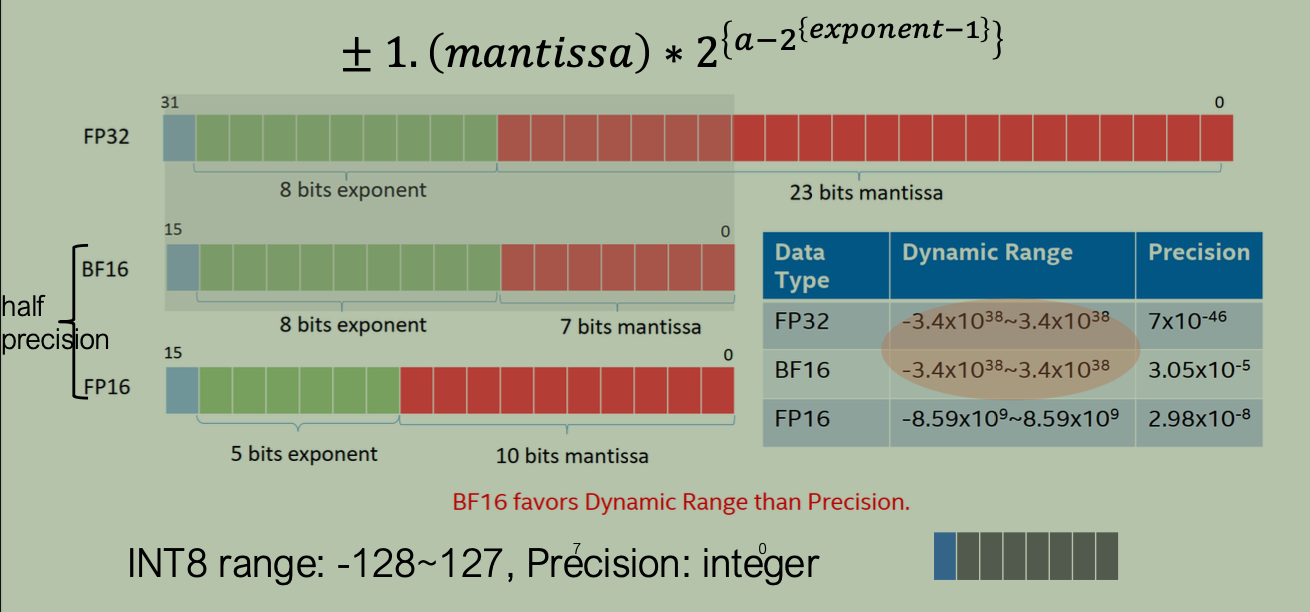
- 浮点数表示:符号位 + 指数位 + 尾数位,表示数字计算方式: \(\pm 1.\text{mantissa} \times 2^{a -
2^{\text{exponent}-1} - 1}\)
- FP32(32位单精度浮点数):
- 位元分配:1 位符号位 + 8 位指数位 + 23 位尾数位。
- 动态范围:\(-3.4 \times 10^{38} \sim 3.4 \times 10^{38}\)。
- 精度:约为 \(7 \times 10^{-46}\),提供最高的数值精度但占用最大的内存与算力。
- FP16(16位半精度浮点数):
- 位元分配:1 位符号位 + 5 位指数位 + 10 位尾数位。
- 动态范围:\(-8.59 \times 10^{9} \sim 8.59 \times 10^{9}\)。
- 精度:约为 \(2.98 \times 10^{-8}\);相比 FP32 节省一半内存,但由于指数位较少,在深层网络训练中容易发生数值上溢或下溢。
- BF16(16位 Brain Floating Point):
- 位元分配:1 位符号位 + 8 位指数位(与 FP32 相同)+ 7 位尾数位。
- 动态范围:与 FP32 完全相同(\(-3.4 \times 10^{38} \sim 3.4 \times 10^{38}\))。
- 精度:约为 \(3.05 \times 10^{-5}\)。
- 关键结论:BF16 相比精度更注重动态范围(BF16 favors Dynamic Range than Precision)。这使得它能有效避免梯度溢出,成为大语言模型(LLM)训练与推理的标配格式。
- FP32(32位单精度浮点数):
- INT8(8位定点整数):
- 数值范围:\(-128 \sim 127\)。
- 精度:整数精度。在量化过程中,算法将高精度的浮点数(如 FP32/FP16)压缩映射到 INT8 的离散整数区间内,以实现存储与加速的收益。
半精度浮点数计算速度优势
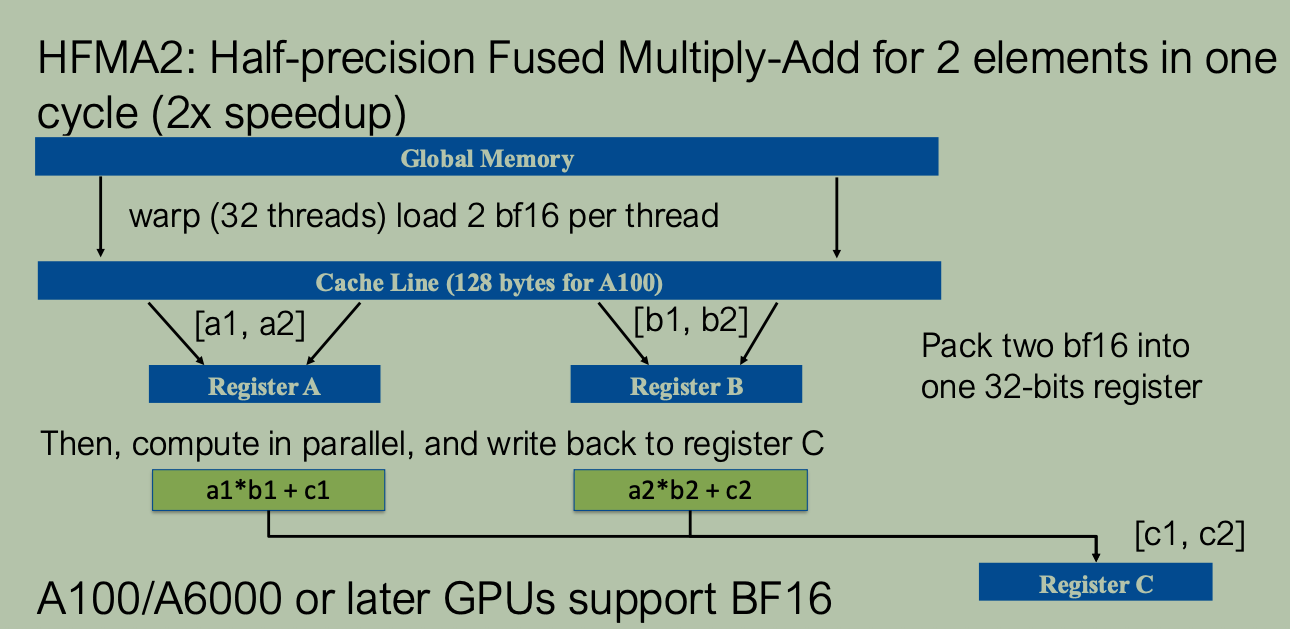
- GPU 内部提供了 HFMA2(Half-precision Fused Multiply-Add for 2 elements) 指令,即半精度融合乘加指令。
- 加速效果:能够在单个时钟周期(one cycle)内同时并行计算 2 个元素的乘加操作,从而带来 2 倍的计算加速(2x speedup)。
CUDA APIs for Half Precision
__hadd2(const __half2 a, const __half2 b): 在“舍入到最近偶数(round-to-nearest-even)”模式下,执行__half2(包含 2 个半精度浮点数的向量)的向量加法。__hfma2(const __half2 a, const __half2 b, const __half2 c): 在“舍入到最近偶数”模式下,执行__half2的向量融合乘加运算。
1.3 Direct Quantization Approach
- 使用低精度
- 将参数从 fp32 转换为 int8 或者 int4 格式
- 在低精度下执行所有运行
- 问题:
- 精度损失(Loss of Precision):引发量化噪声(Quantization Noise)的逐层累积。
- 数值范围错配(Range Mismatch):极端数值被强制截断(Clipping),导致关键信息丢失。
- 量化误差(Quantization Error):由于浮点数取整舍入(Rounding Errors)带来的数学偏差。
- 量化方法:
- Absmax quant
- Zero-point quant
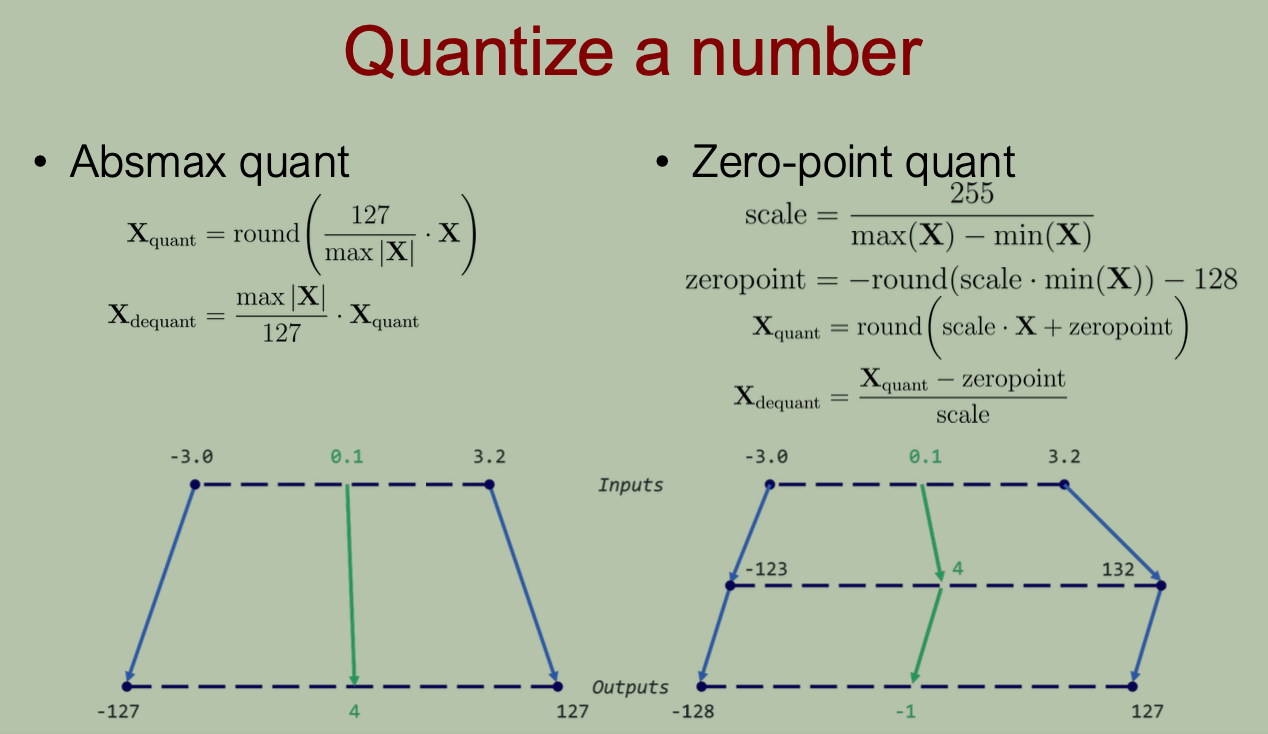
- 下面的 Absmax & Zero-point 两个简单量化方法,本质是都是在做一个一次函数映射,所谓的 scale 相当于直线斜率,所谓的零点是直线不过零点时的 \(y=kx + b\) 中的 \(b\)。
- 标量量化本质上就是做一次函数映射 \(y = kx + b\):把连续的浮点区间先按斜率 \(k\) 缩放、再按截距 \(b\) 平移,整体‘套’进 INT8 的整数网格里;Scale 就是网格步长(\(\frac{1}{k}\)),Zero-point 就是把截距 \(b\) 锁死成整数后的原点投影。
Absmax 量化
Absmax 是最基础的对称量化方法,它根据数据矩阵中最大的绝对值进行等比例缩放,将数值对称线性映射到 \([-127, 127]\) (注意:这里取最大值是 127,而不是 int8 的表示范围 \([-128, 127]\) ,这与下面的 scale 计算方式取 \(\max |X|\) 有关,需要取整数取值最大值 127 作为 scale 计算参数)的 INT8 范围。
数学公式:
- 量化(Quantization): 其中 \(\frac{127}{\max |X|}\) 为 scale。
\[ X_{\text{quant}} = \text{round}\left( \frac{127}{\max |X|} \cdot X \right) \]
- 反量化(Dequantization):
\[ X_{\text{dequant}} = \frac{\max |X|}{127} \cdot X_{\text{quant}} \]
PyTorch 代码实现:
1 | |
Zero-point 量化
当输入数据的分布非对称(例如激活值经过 ReLU/GeLU 后全为正数,或分布极度偏向某一侧)时,Absmax 会浪费表示空间。Zero-point 量化通过引入零点偏移量(Zero-point),将数据区间 \([\min(X), \max(X)]\) 完整映射到 INT8 的 \([-128, 127]\) 全范围(区间长度为 255)。
数学公式:
- 缩放因子(Scale):
\[ \text{scale} = \frac{255}{\max(X) - \min(X)} \]
- 零点偏移量(Zero-point):
\[ \text{zeropoint} = -\text{round}(\text{scale} \cdot \min(X)) - 128 \]
这一步本质在将区间的左端点 \(\text{scale} \cdot x_{\min}\) 平移到 int8 表示范围的最左侧,即:\(\text{scale} \cdot x_{\min} + \text{zeropoint} = -128 \implies \mathbf{\text{zeropoint} = -\text{round}(\text{scale} \cdot x_{\min}) - 128}\) ,变换后进一步得到零点表示(Zero-point 就是真实的浮点数 \(0.0\) 在量化后的整数空间中所对应的那个整数值)。
- 量化(Quantization):
\[ X_{\text{quant}} = \text{round}(\text{scale} \cdot X + \text{zeropoint}) \] 注:实际代码中会使用 clip 将数值限制在 [-128, 127] 范围内)
- 反量化(Dequantization):
\[ X_{\text{dequant}} = \frac{X_{\text{quant}} - \text{zeropoint}}{\text{scale}} \]
PyTorch 代码实现:
1 | |
Reference:
2. Basic Quantization Methods
量化方法可以分为训练中和训练后两类:
- Quantization-Aware Training (QAT) incorporates the weight conversion process during the pre-training or fine-tuning stage, resulting in enhanced model performance. However, QAT is computationally expensive and demands representative training data.
- Post-Training Quantization (PTQ) is a
straightforward technique where the weights of an already trained model
are converted to lower precision without necessitating any retraining.
Although easy to implement, PTQ is associated with potential performance
degradation.
- preserve accuracy(hard to scale to large parameters (billions))
- AdaQuant (Hubara et al., 2021)
- BRECQ (Li et al., 2021)
- OBQ (Frantar et al., 2022)
- scale to large parameters(accuracy loss when lower-bit precision
(ex. 3, 4 bits per parameter))
- ZeroQuant (Yao et al., 2022)
- LLM.int8() (Dettmers et al., 2022)
- preserve accuracy(hard to scale to large parameters (billions))
Basic Approach: Layer-Wise Quantization
- 直接对参数量化容易引发误差累积,因此基础逐层量化提出:在逐层进行线性投影时,寻找一个量化后的权重矩阵 \(\hat{W}\),使其输出尽可能贴近原始全精度矩阵 \(W\) 的输出。
- 转化为优化问题:最小化输出误差
\[ \arg\min_{\hat{W}} \| W X - \hat{W} X \|_2^2 \]
- 其中:
- \(W\):原始全精度的线性投影权重矩阵(例如 Transformer 中的 FFN 和 Self-Attention)。
- \(\hat{W}\):所要求解的目标量化权重矩阵。
- \(X\):当前层的输入激活值。
- 问题:仍然会导致量化误差在逐层叠加中不断累积(accumulation of quantization error)。
2.1 AdaQuant
- 上述朴素 Layer-Wise Quantization 缺点:没有考虑输入激活值 \(X\) 在实际推理中也会被量化的情况,并且缺少优化的自由度,因而误差仍会在深层网络中不断累积。
- AdaQuant 优化目标:
\[ (\hat{\Delta w}, \hat{\Delta x}, \hat{V}) = \arg\min_{(\Delta w, \Delta x, V)} \left\| W X - Q_{\Delta w}(W + V) \cdot Q_{\Delta x}(X) \right\|_2^2 \]
其中:
- \(W X\)(基准
Target):
- 原始全精度(FP32/FP16)线性层的真实输出结果。\(W\) 为全精度权重,\(X\) 为传入该层的全精度激活值。
- \(V\)(连续修正矩阵 /
Continuous Offset Matrix):
- AdaQuant 的核心创新。因为量化函数 \(Q(\cdot)\) 是不可导的,直接对取整后的权重求导无法优化。
- AdaQuant 在量化前给原权重叠加了一个连续可微的微调矩阵 \(V\)(即计算 \(W + V\))。在小批量校准数据上,通过梯度下降来微调 \(V\),使量化后的权重能够拟合出更好的局部极小值。
- \(\Delta w\) 与
\(\Delta x\)(量化步长 / Step
Sizes):
- 分别代表权重和激活值的量化步长(Scale)。它们决定了连续浮点数被划分到哪个离散的整数网格中。
- 在 AdaQuant 中,这两个步长不仅可以手动设定,还可以作为可学习参数通过梯度下降进行优化。
- \(Q_{\Delta w}(\cdot)\)
与 \(Q_{\Delta
x}(\cdot)\)(量化函数):
- 分别对“修正后的权重 \(W+V\)”和“输入激活值 \(X\)”执行带步长的量化与反量化操作。
- \(\|\cdot\|_2^2\)(L2 范数
/ 均方误差):
- 衡量“全精度输出 \(W X\)”与“量化后输出 \(Q_{\Delta w}(W + V) \cdot Q_{\Delta x}(X)\)”之间的均方误差。
- 量化函数如何进行反向传播:
- 使用:直通估计器(Straight-Through Estimator, STE)
- \(V\) 求导:
- 前向传播(Forward):严格执行真实的量化取整逻辑 \(Q_{\Delta w}(W+V)\),得到离散的量化值。
- 反向传播(Backward):在计算导数时,人为将取整函数的导数近似替代为 (即恒等映射): \(\frac{\partial Q(y)}{\partial y} \approx 1\)
- 作用:梯度不会因为取整函数而中断,损失函数 \(\mathcal{L} = \| W X - Q_{\Delta w}(W + V) \cdot Q_{\Delta x}(X) \|_2^2\) 对量化输出的梯度,能够无损地穿透 \(Q(\cdot)\) 直接传递给 \(V\)。
- \(\Delta w\) 与 \(\Delta x\) 求导:
假设一个标准的量化函数为(其中 \(\Delta\) 为 scale): \[ Q_\Delta(z) = \Delta \cdot \text{round}\left(\frac{z}{\Delta}\right) \]
为了书写简便,我们令 \(y = \frac{z}{\Delta}\),取整后的离散整数为 \(\hat{z} = \text{round}(y)\)。那么量化输出就是:
\[ Q_\Delta(z) = \Delta \cdot \hat{z} \]
现在我们对步长 \(\Delta\) 求偏导(运用乘积法则与链式法则):
\[ \frac{\partial Q_\Delta(z)}{\partial \Delta} = \frac{\partial (\Delta \cdot \hat{z})}{\partial \Delta} = \hat{z} + \Delta \cdot \frac{\partial \hat{z}}{\partial \Delta} \]
接下来关键的一步,利用直通估计器(STE),将取整函数的导数近似为 1(即 \(\frac{\partial \text{round}(y)}{\partial y} \approx 1\)):
\[ \frac{\partial \hat{z}}{\partial \Delta} = \frac{\partial \text{round}(y)}{\partial y} \cdot \frac{\partial y}{\partial \Delta} \approx 1 \cdot \left( -\frac{z}{\Delta^2} \right) = -\frac{z}{\Delta^2} \]
将结果代回最上面的求导公式中,得到:
\[ \frac{\partial Q_\Delta(z)}{\partial \Delta} \approx \hat{z} + \Delta \cdot \left( -\frac{z}{\Delta^2} \right) = \hat{z} - \frac{z}{\Delta} = \text{round}\left(\frac{z}{\Delta}\right) - \frac{z}{\Delta} \]
最后的求导结果:\(\text{round}\left(\frac{z}{\Delta}\right) - \frac{z}{\Delta}\) 正好就是舍入误差(Quantization / Rounding Error):
- 内部未截断区域(Rounding Area):梯度的方向和大小完全由当前的“舍入偏差”决定。梯度下降会自动调整 \(\Delta\) 的大小,使得网格间距尽可能去匹配数据分布,从而降低平均舍入误差。
- 边界截断区域(Clipping Area):如果数值 \(z\) 太大超出了 INT8 范围(即触发了
clip截断),比如被截断为最大值 \(q_{max}\),此时 \(Q_\Delta(z) = \Delta \cdot q_{max}\)。- 对 \(\Delta\) 求导直接结果就是 \(q_{max}\)
- 物理含义:如果有太多的数值被截断丢失了信息,梯度会产生一个强有力的推力将 \(\Delta\) 放大,从而拓宽动态范围,减少截断损失。
2.2 ZeroQuant
- 逐层知识蒸馏(Layer-by-layer knowledge distillation)
- 原始高精度模型作为 Teacher
- 量化模型作为 Student
- 优化目标:
\[ \mathcal{L}_{LKD, k} = \left\| L_k \cdot L_{k-1} \cdot \dots \cdot L_1 (X) - \tilde{L}_k \cdot \tilde{L}_{k-1} \cdot \dots \cdot L_1 (X) \right\|_2^2 \]
其中:
\(L_k\):代表教师模型第 \(k\) 层的输出。
\(\tilde{L}_k\):代表学生模型第 \(k\) 层的量化输出。
核心逻辑:在校准第 \(k\) 层时,输入 \(X\) 会同时通过教师模型和学生模型的前 \(k-1\) 层累积计算;通过最小化第 \(k\) 层输出的 L2 范数距离(蒸馏损失 \(\mathcal{L}_{LKD, k}\)),来精确调整第 \(k\) 层的量化参数与步长,从而确保量化后的学生模型能最大程度复现教师模型的逐层表示。
通过 kernel fuse 优化性能,示意图如下:
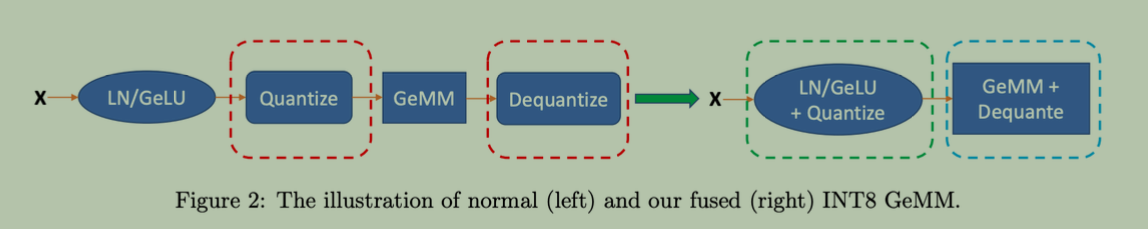
- 原始计算形式:
- Norm/Activation
- 量化
- GEMM
- 反量化
- fuse 后:
- Norm/Activation + 量化
- GEMM + 反量化
- ZeroQuant 性能:
- 成功在 20B 规模模型(GPT-NeoX-20B) 上验证了可扩展性。
- 对于 1.3B 规模的模型,蒸馏校准计算时间约为 3 小时
- 校准速度仍不及后续的 GPTQ(GPTQ 可以在约 4 小时内完成比其大 100 倍模型的量化)。
2.3 LLM.int8()
- 问题与背景
- 当 Transformer 模型的参数规模突破 6.7B 阈值时,模型的激活值中会突然涌现出极少数数值巨大(如绝对值 \(\ge 6.0\))的“离群特征”(Outlier Features)**。
- 如果使用传统的 8-bit 均匀量化(如 Absmax),为了把这些极大的离群值囊括进来,缩放因子 Scale 会被拉大,导致占绝大多数(99.9% 以上)的常规数值被挤压映射到极少数 INT8 离散网格里,造成严重的信息丢失与精度崩塌(Accuracy Degradation)。
- 如下图所示:
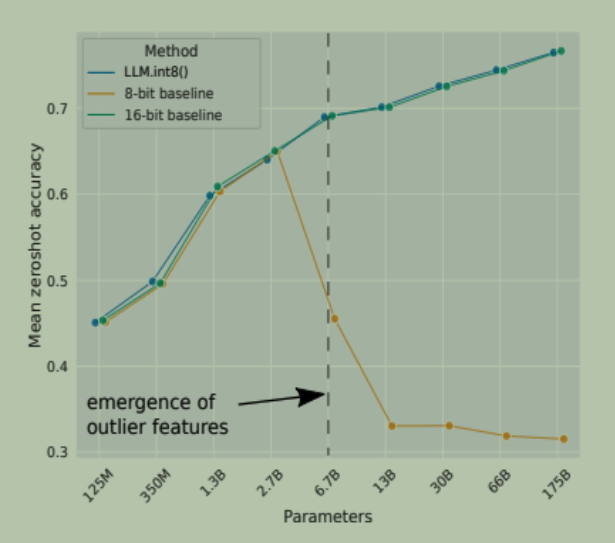
- 橙线(8-bit baseline):在 6.7B 参数前表现正常,但在 6.7B 节点后由于离群特征的涌现,准确率发生“断崖式”下跌。
- 绿线(16-bit baseline) 与 蓝线(LLM.int8()):LLM.int8() 的准确率曲线与全精度 FP16 曲线完全重合,成功将 INT8 量化扩展到了 175B 规模。
方法示意图如下:
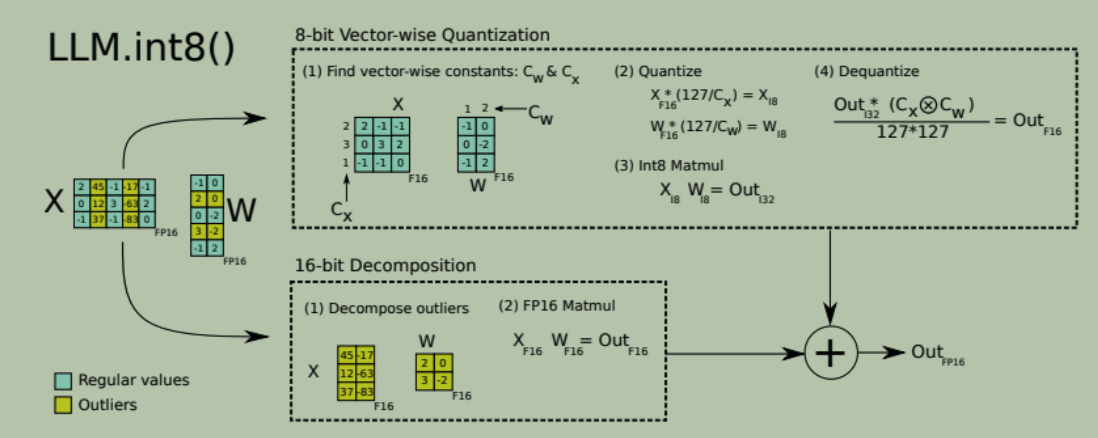
- 离群特征的定义:
- 满足 数值极大(\(\ge 6.0\))、存在于超 25% 的层,且集中分布在约 6% 的特征序列维度(即呈现列状分布)。
- 混合计算流程:普通值用 int8 计算,离群值用 fp16
计算,然后二者结果相加
- 第一步:拆分(Decomposition):
- 将输入激活矩阵 \(X\) 和权重矩阵 \(W\) 按照列/行进行拆分。
- 常规数值(上图蓝块):占 99% 以上的普通特征,转入 INT8 路径。
- 离群数值(上图黄块):提取出这 6% 包含离群值的特定列,保留 FP16 高精度。
- **第二步:并行矩阵乘法:
- 8-bit 向量级量化路径:对常规数值执行 INT8 矩阵乘法。这里采用了向量级缩放(Vector-wise Quantization)——对 \(X\) 按行计算缩放常数 \(C_x\),对 \(W\) 按列计算 \(C_w\),比整个矩阵共享单个 Scale 更精细。
- 16-bit 高精度路径:对离群列直接执行常规的 FP16 矩阵乘法 \(X_{F16} W_{F16}\)。
- 第三步:反量化与结果相加(Dequantize & Add):
- 将 INT8 矩阵乘法的结果反量化还原为 FP16,与 FP16 离群路径的乘积直接相加(\(\text{Out}_{F16} = \text{Out}_{\text{INT8}} + \text{Out}_{\text{FP16}}\)),得到最终的输出矩阵。
- 第一步:拆分(Decomposition):
3. Conclusion
- low-bit number representation in computer
- BF16: 16-bit half precision floating point numbers, better for ML
- int8
- Direct quantization
- Absmax: linearly scale according to max abs value
- Zero-point: finding zero-point and scale
- Layer-wise quantization approaches
- AdaQuant
- KD: ZeroQuant
- LLM.int8()