LLM Systems 09: Decoding: Sampling, Beam Search and Speculative Decoding
0. Recap
- Subword tokenization: Byte-Pair-Encoding
- iteratively merging most frequent pairs of tokens
- Information-theoretic vocabulary (VOLT)
- solving entropy constrained optimal transport problem
- Pre-tokenization through regex
- Number treatment
- Vocab sharing impact multilingual performance
- how to solve languages in stagnant quadrant
1. Sequence Decoding overview
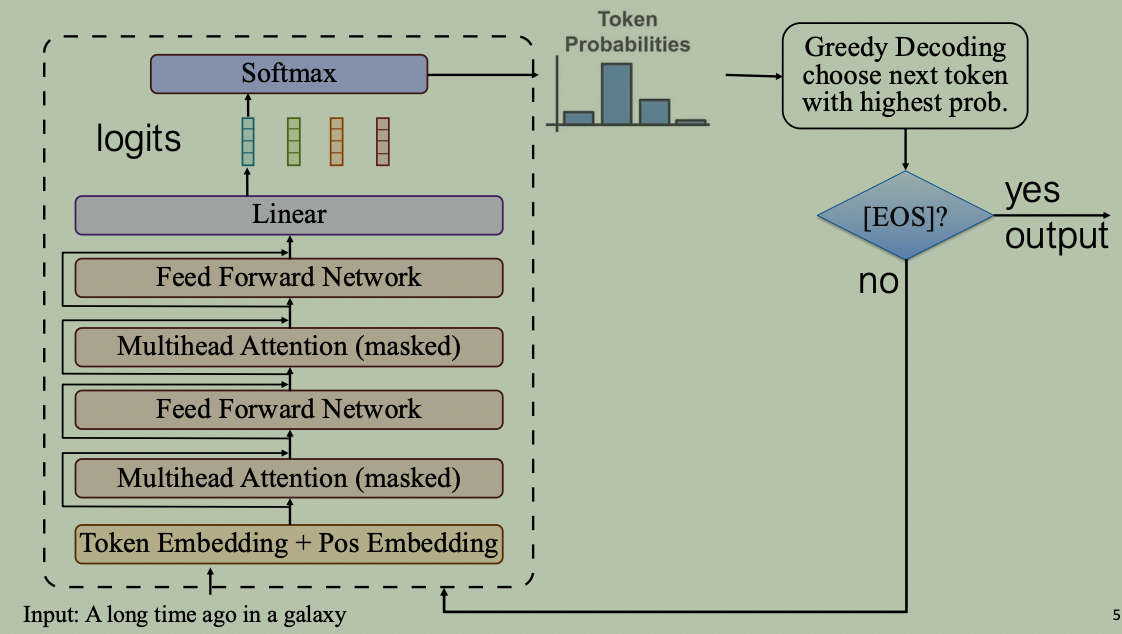
贪婪解码(Greedy Decoding)图示:
1.1 Max Decoding
选择概率最大的 next token: \[ \max {p(x_t | x_{1...t-1})} \] 等价于选择 logits 最大的 token,不需要正则化计算概率。
1.2 Sampling
不是直接取概率最大的项作为 next token,而是根据输出分布 \(P(Y|X)\) 生成序列。
离散采样建模
从 \(k\) 个类别,概率分布为:\(p_1\),\(p_2\),...,\(p_k\) 中采样 \(n\) 个值。
- 直接采样(Direct sampling):复杂度为 \(O(nk)\)。
- 二分查找(Binary Search):复杂度为 \(O(k + n\log k)\)。
- 别名采样(Alias sampling):复杂度为 \(O(k\log k + n)\)。
PyTorch 实现:
1 | |
Fast Sampling with Gumbel Max Trick
- 数学原理: 从 Categorical(\(\text{Softmax}(h)\)) 分布中采样,在数学上等价于向原始 Logits \(h\) 中添加标准 Gumbel 噪声后取 \(\arg\max\):
\[ x = \arg\max_{x} \left( h - \log(-\log z) \right), \quad z \sim \text{Uniform}(0, 1) \] - 当 \(z\) 服从均匀分布时,\(g = -\log(-\log z)\) 遵循 Gumbel 分布,其 \(\arg\max\) 结果正好符合指数归一化后的 Categorical 分布。 - 核心优势: - 绕过 Softmax 计算:不需要先对全词表计算 Softmax 归一化概率,直接在 Logits 上操作,提升了计算效率。
代码实现:
1 | |
Improving Quality in Sampling
- Top-k sampling
- Sample from top-k tokens, discard the remaining
- Top-p sampling
- selects top tokens whose cumulative probability exceeds a hyber-parameter p
- Controlling temperature T: 模型输出 logits 在进行 softmax 计算之前,先对所有 logits 除以 T,以达到让 softmax 后概率分布更加平坦或尖锐。 \[ P(y_i) = \frac{\exp(h_i / T)}{\sum_{j} \exp(h_j / T)} \]
- higher(T > 1.0): 放大不同 Logits 之间的差距,使 Softmax 后的概率分布变得非常尖锐(Sharp)。高概率 Token 的概率被进一步拉大,低概率 Token 的概率被极大压缩。
- lower(T < 1.0): 缩小不同 Logits 之间的差距,使概率分布变得更加平坦(Flat/Uniform)。原本概率较低的长尾 Token 获得了更高的被抽中机会。当 \(T \to 0\) 时,采样行为无限趋近于贪婪解码。
2. Beam Search Algorithm
Beam Search 执行流程示意图:
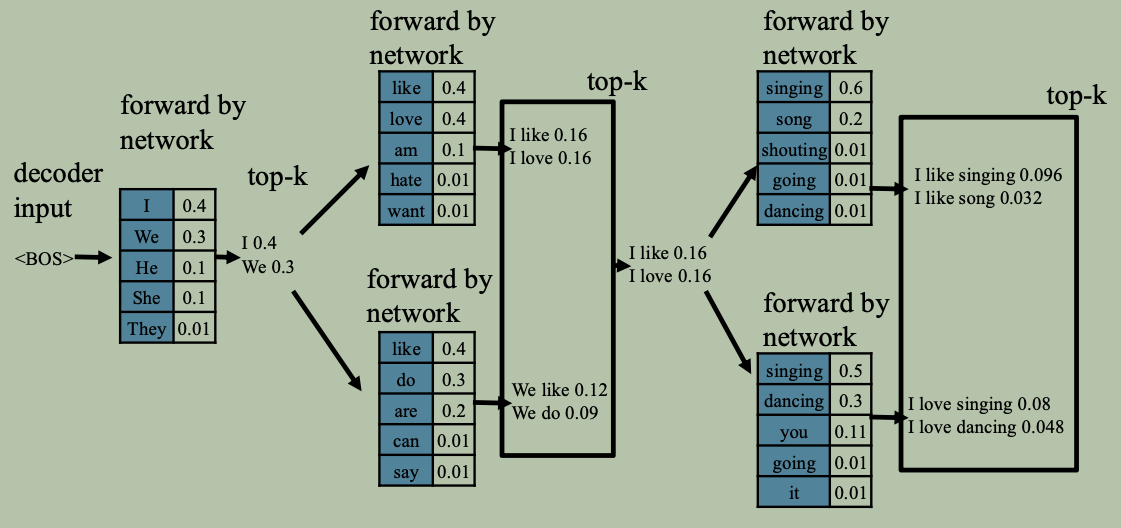
- 上图展示了 \(k = 2\) 时 Beam Search 执行流程。
- 形式化的,Beam Search 算法流程如下:
- 初始化:从空序列或起始标记
<BOS>开始,得分设为 0.0。 - 逐步扩展:在生成每个位置的 Token 时,利用模型对当前保留的 \(k\) 个候选序列分别预测下一个 Token 的概率。
- 分数累加:将新 Token
的条件对数概率与原序列分数相加(
new_score = s + score)。- 注意:上面图示计算过程是概率累乘,实际工程实现,由于概率累乘后可能很小影响数值精度,实际上是对概率取对数作为分数,然后进行累加。
- Top-\(k\) 筛选:利用优先队列维护大小为 \(k\) 的集合,仅保留所有扩展序列中对数概率和最大的前 \(k\) 个序列。
- 终止判定:当序列生成终止符
<EOS>或达到预设最大长度max_length时停止扩展。
- 初始化:从空序列或起始标记
伪代码:
1 | |
Beam Search 剪枝:
- 相对阈值剪枝(Relative threshold pruning):当某个候选序列的分数低于当前最高分数的固定比例 \(r_p\)(即 \(\text{score}(cand) \le r_p \cdot \max\{\text{score}(c)\}\))时,直接将其剔除。
- 绝对阈值剪枝(Absolute threshold pruning):当某个候选序列的分数与当前最高分数的差值超过绝对阈值 \(a_p\)(即 \(\text{score}(cand) \le \max\{\text{score}(c)\} - a_p\))时,将其剔除。
- 相对局部阈值剪枝(Relative local threshold pruning):在局部扩展阶段针对当前步骤的候选分布进行相对阈值过滤(即:仅 next token 概率进行剪枝而不是累积概率)。
Combine Sample and Beam Search
在实际大模型推理中,通常会叠加使用 Sample 与 Beam Search:
- Temperature:先对整体概率分布进行重塑(调整平坦/尖锐度)。
- Top-k / Top-p:在重塑后的分布上截断长尾低概率 Token(Top-k 保留前 \(k\) 个词,Top-p 保留累积概率达到 \(p\) 的候选集),剔除低质量词。
- Multinomial 采样:从过滤后的候选集中抽样生成下一个 Token。
- Beam Search:在采样基础上继续进行 Beam Search。
- 目的:提升生成序列的多样性。
3. Accelerating Generation: Speculative Decoding
3.1 LLM 自回归生成的问题:速度慢
自回归生成流程示意图:
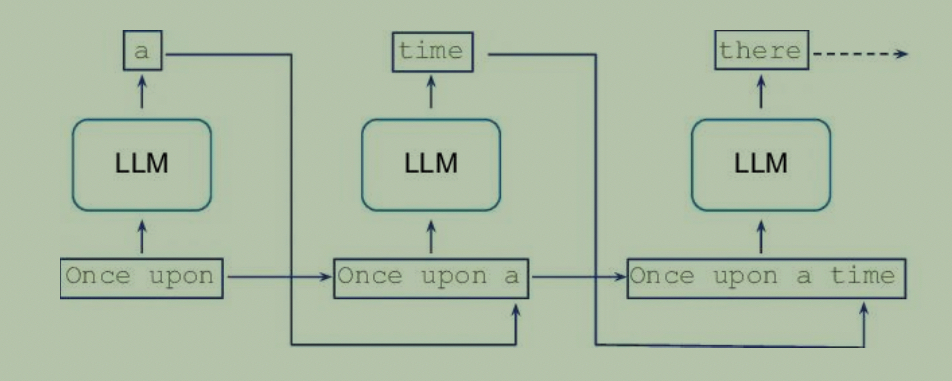
- 需要以顺序方式逐个 token 生成,每生成一个 token 可能需要 100+ ms。
3.2 Speculative Decoding(投机解码)
投机解码发展路线:
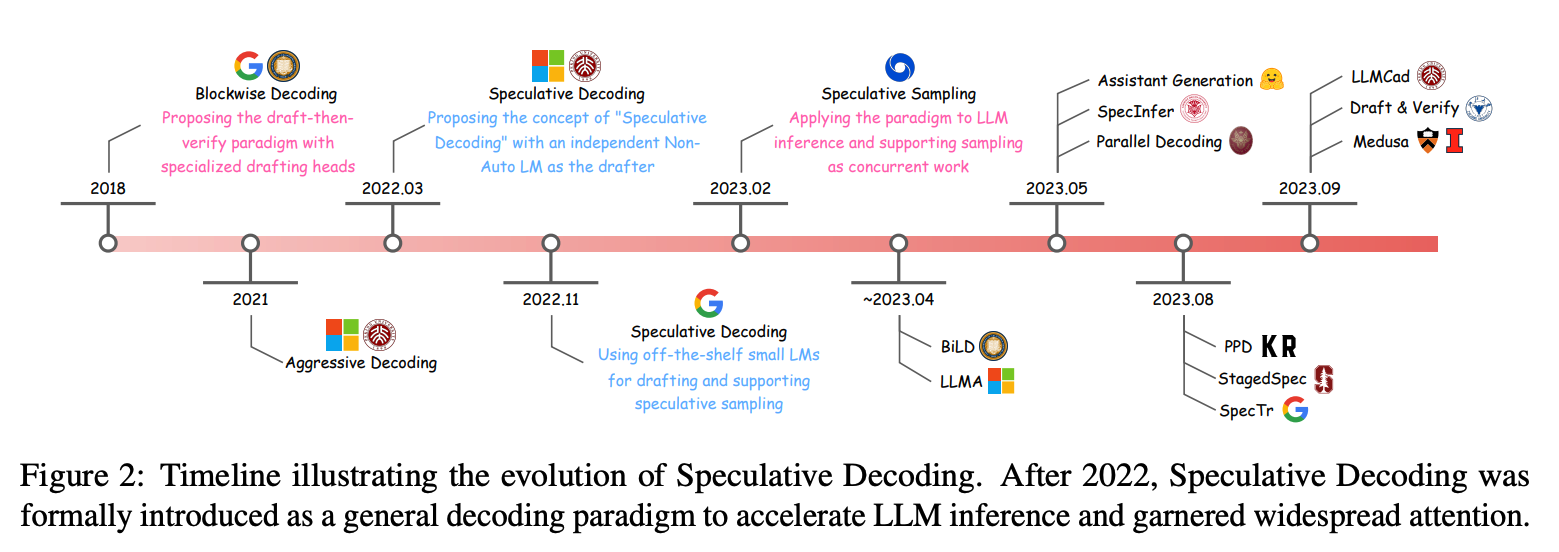
核心思想:
- 首选使用一个 草稿模型(Draft Model,小模型) 快速连续生成 \(N\) 个候选 “草稿 Token”(Draft Tokens)。
- 然后使用 目标模型(Target Model,大模型) 一次性并行验证这 \(N\) 个草稿 Token。
上述流程如下图所示:
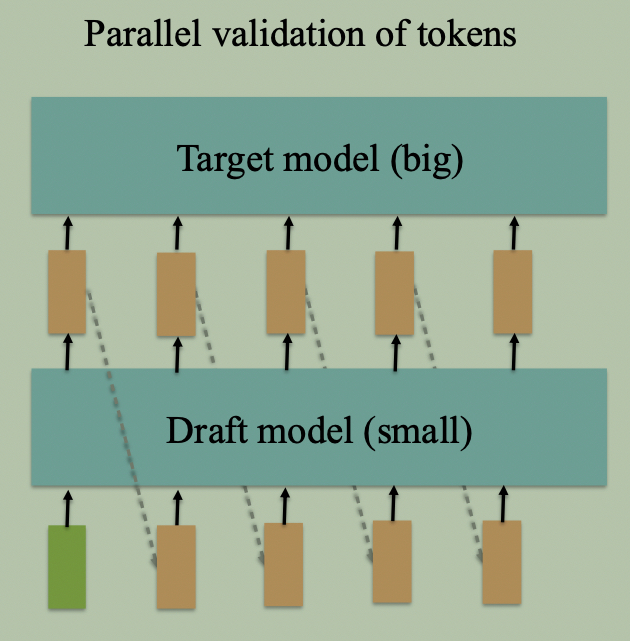
- 使用 Draft model 自回归生成 \(N\) 个 draft tokens。
- 使用 Target model 并行验证 \(N\) 个 draft tokens。
验证与拒绝机制(TopK Verification & Rejection)
目标模型逐个校验草稿模型给出的序列 \(y_1, y_2, \dots, y_N\)。
- 接受规则:对于第 \(i\) 个草稿 Token \(y_i\),如果它落入目标模型在该位置预测概率的 Top-K 列表中(即 \(y_i \in \text{TopK}(f_{\text{target}}(\cdot | x, y_{1:i-1}))\)),则该 Token 被接受。
- 拒绝与修正:一旦某个草稿 Token 被拒绝,后续的草稿 Token 将全部废弃。目标模型会从最后一个被接受的 Token 处接管,并直接自行生成正确的替换 Token。
为什么投机解码可以加速?
- 单次前向传播并行验证:借助于因果注意力机制(Causal Attention),目标模型在一次 forward 中就能计算出这 \(N\) 个草稿 Token 的条件概率,而不需要做 \(N\) 次串行生成。
- 速度与质量双保障:并行验证 Token 的速度远快于逐字生成。同时,Top-K 校验机制保证了最终生成的文本序列分布不会偏离目标模型原本的输出质量。
关键超参数与模型对齐
- 草稿长度 \(N\)
的选择:
- \(N\) 设得越大,理论上单次能达到的加速上限越高,但草稿被拒绝的风险和 Softmax 计算(可能是内存带宽瓶颈)代价也会增加。
- 实践中最常用的取值为 \(N = 4\) 或 \(8\)。
- 模型对齐(Model Alignment):
- 投机解码能否显著提速,取决于草稿模型与目标模型的对齐度(即较低的拒绝率)。一旦频繁发生拒绝,加速优势就会被抵消。
- 通常选用 同一模型家族 的同源大小模型配对(如小版本与大版本 LLaMA)以获得最佳对齐效果。
4. Further Improvement: EAGLE speculative decoding
Motivation
- 朴素投机解码:使用一个小的语言模型作为 draft model 预测下一个 token。
- 观察:预测下一个 LLM 最后一层的特征(the next LLM final layer feature)比预测下一个 token 更简单。
- EAGLE 直接用一个小模型预测下一个 LLM 最后一层的特征。
Overview
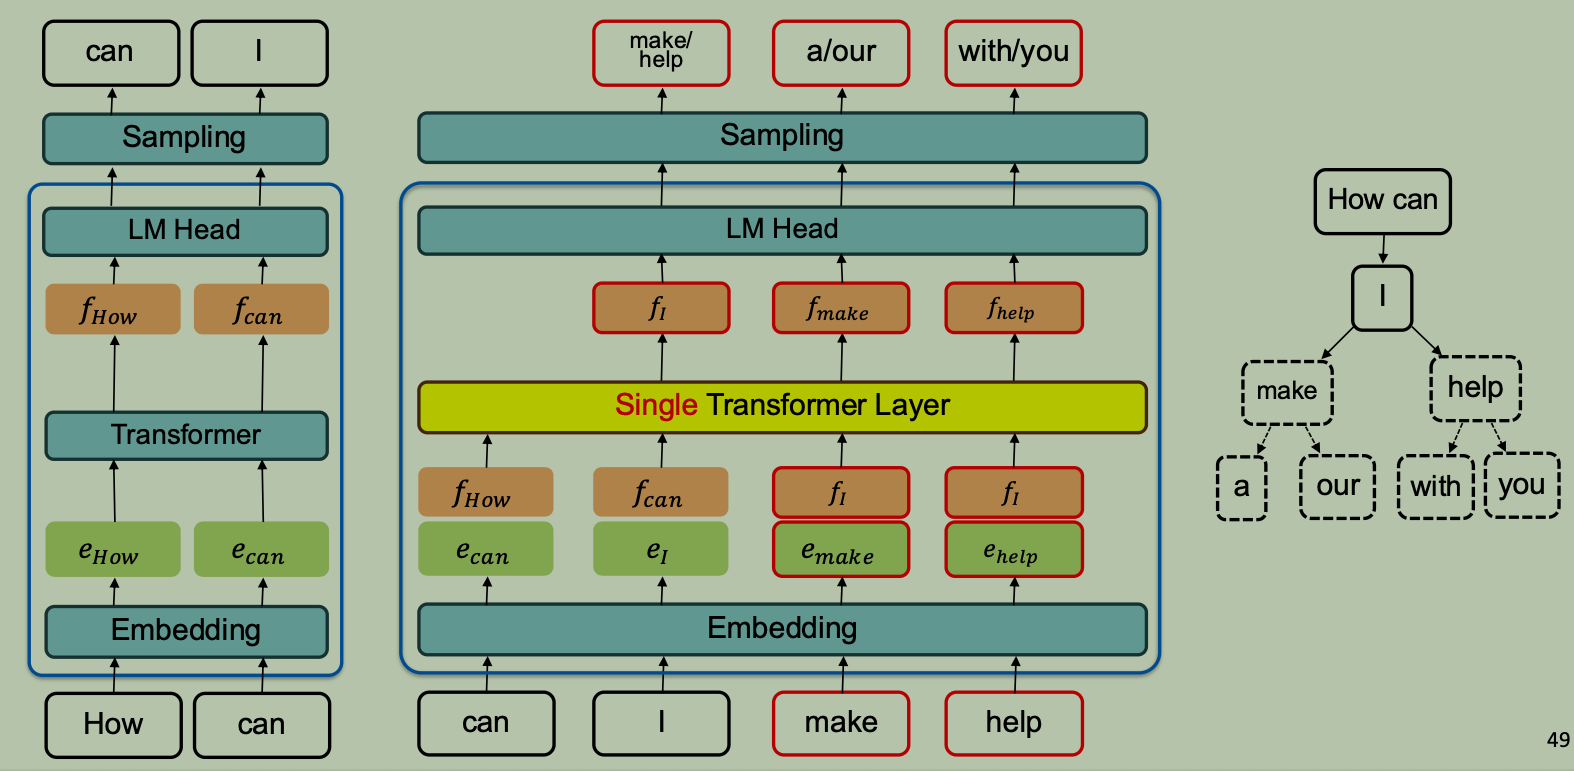
- 架构复用:EAGLE 直接复用了原始大模型的词嵌入层(Embedding)和输出头(LM Head),中间仅使用一个极其轻量的小型 Transformer 层(如单层 Transformer)来预测特征。
- 输入:Draft Model 预测下一个特征时,输入的不仅是上一位置的特征向量 \(f_i\),还结合了采样出的 Token 对应的词向量(Word Embedding \(e_{i+1}\))。这是因为抽样选出的具体 Token 对后续特征走向有很大影响(The sampled token affects the final layer feature a lot.)。
树状注意力掩码(Tree Attention Mask)
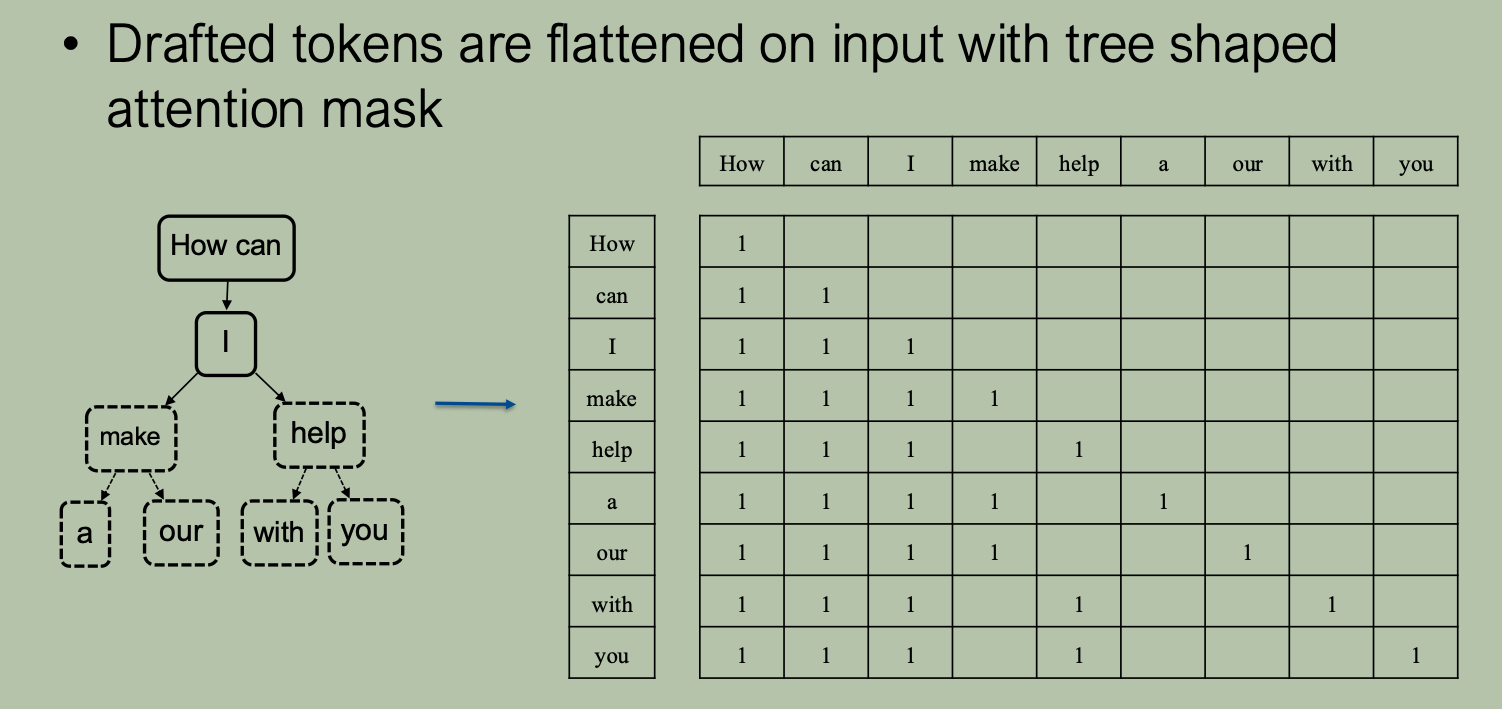
- 候选树构造:EAGLE 在生成草稿候选时,并非只生成单条线性序列,而是扩展成一棵多分支的草稿树(Tree-shaped structure)。
- 并行验证:在 Target Model 验证阶段,将树状候选序列展开(Flatten),并应用树状注意力掩码(Tree Attention Mask)。大模型仅需一次前向传播,就能同时验证多条分支路径,大幅提升了草稿 Token 的接受率。
EAGLE Training
EAGLE 采用自回归方式训练,其损失函数由两部分加权组合(\(L = L_{reg} + w_{cls} L_{cls}\))。
- 特征回归损失(\(L_{reg}\)):使用 Smooth L1 Loss,使 Draft Model 预测的特征向量尽可能贴近大模型真实的最后一层特征向量。
- 分类损失(\(L_{cls}\)):使用交叉熵损失(Cross Entropy Loss),确保预测特征通过 LM Head 映射后的 Token 概率分布与目标模型对齐。
Further Improvement on EAGLE
- EAGLE-2 prunes the tokens in tree with low confidence.
- EAGLE-3 scales the method to larger training data.
5. Conclusion
- Beam Search decoding: approximate dynamic programming to keep a beam of partial sequences.
- Speculative decoding makes LLMs decoding phase faster.
- key idea: It uses a draft model to generate tokens and uses the target model to validate them.
- The speed up comes because validating tokens is faster than generating them.
- EAGLE: use the original LM’s embedding and LM head, and a small
Transformer layer to predict the final layer features for prediction.
- implementing with tree attention mask.