DDP: PyTorch Distributed-Experiences on Accelerating Data Parallel Training
- PyTorch Distributed: Experiences on Accelerating Data Parallel Training
- 代码:PyTorch DDP
- arXiv 提交日期:28 Jun 2020 (发表于 VLDB 2020)
- 作者:
摘要:
本文介绍了 PyTorch 分布式数据并行(Distributed Data Parallel, DDP)模块的设计、实现与评估。 PyTorch 是一套在深度学习研究与应用中被广泛采用的科学计算包。深度学习领域的最新进展强调了大数据集和大模型的价值,这使得将模型训练扩展到更多计算资源成为必要。得益于其直观的原理和广泛的适用性,数据并行已成为分布式训练的一种主流解决方案。
通常,分布式数据并行技术会在每个计算资源上复制模型副本以独立生成梯度,并在每次迭代时对这些梯度进行同步通信,以保持各模型副本的一致性。尽管该技术在概念上很简单,但计算与通信之间微妙的依赖关系使得优化分布式训练效率绝非易事。
截至 v1.5 版本,PyTorch 原生提供了几种加速分布式数据并行的技术,包括梯度分桶(Bucketing Gradients)、计算与通信重叠(Overlapping Computation with Communication) 以及 跳过梯度同步(Skipping Gradient Synchronization,即:梯度累积)。评估结果表明,在配置得当的情况下,PyTorch 分布式数据并行模块在扩展至 256 块 GPU 时能够实现接近线性的可扩展性。
1. Introduction
问题与背景:
深度学习在许多任务上验证了有效性,许多应用使用更大的模型与数据集以取得更好的效果,随之带来了对分布式训练的需求,其中最广泛使用的分布式训练策略就是本文关注的:DDP(Distributed Data Parallel)。
实现 DDP 的主要挑战:
- 数学等价性(Mathematical equivalence):
- DDP 目的:加速在大规模数据集上的模型训练(切分数据维度)。
- 核心约束:DDP 分布式训练得到的结果模型应该与单节点训练得到的模型相同。
- 非侵入式 API(Non-intrusive and interceptive API):
- DDP API 必须不侵入用户代码,方便用户从 local 模式实现开始,仅需要少量修改就扩展到 DDP。
- 同时,API 设计又必须能够及时感知/拦截信号,以进行通信与系统性能优化。
- 高性能(High performance):
- DDP 本身有计算与通信的依赖。
- 设计与实现必须高效利用不同资源,实现更高的训练吞吐。
Solution:
PyTorch DDP(DistributedDataParallel):
torch.nn.Module的子类,用户构造时传入实现的模型,作为 DDP 的子模块。- 解决上述三个挑战的方法:
- 数学等价性:
- 初始化时模型权重同步(Broadcast);
- 每个训练迭代同步梯度(AllReduce);
- 目的:初始化和训练过程中,保持不同模型 replica 参数始终相同。
- 非侵入式 API:
- DDP 提供与用户模型相同的
forward接口; - 用户使用 DDP 时无需修改其他代码;
- DDP 提供与用户模型相同的
- 高性能:
- 梯度分桶(bucketing gradients);
- 通信计算 overlap(overlapping communication with computation);
- 跳过梯度同步(skipping synchronization);
- 数学等价性:
一些实验经验与结论:
- 通信是 DDP 训练时延的主要因素,且通信对时延影响随着模型规则增加同步增加;
- 桶大小对通信效率影响很大,正确配置时能带来 2+ 倍速度提升;
- 跳过梯度同步能显著减小均摊通信开销,同时对模型收敛速度无显著影响。
2. System Design
Overview:
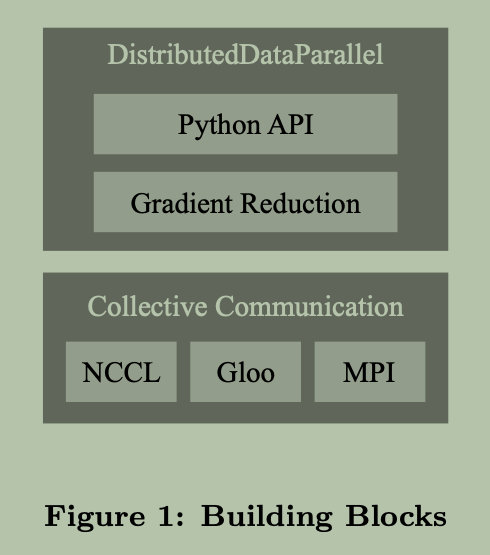
- Python API frontend
- C++ gradient reduction core algorithm
- the
c10dcollective communication library - different communication backend
- NCCL
- Gloo
- MPI
- the
2.1 API
DDP Module,作为 torch.nn
下模块,传入用户自定义模型后,透明地在 backward
时进行梯度通信与同步。
示例代码:
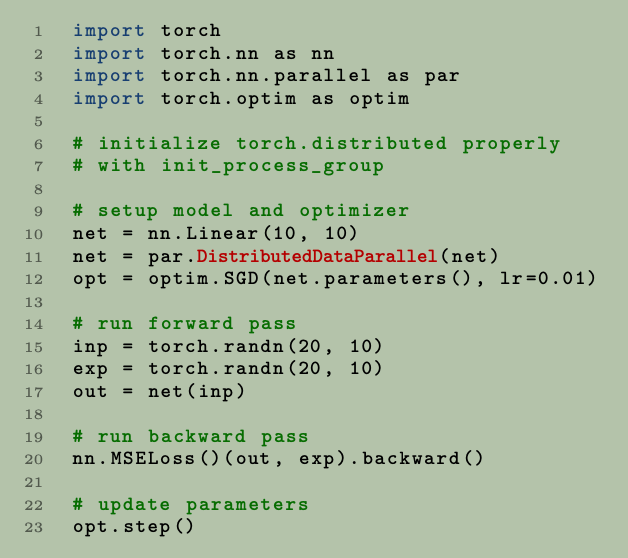
- 仅需要第 11 行 DDP 包装自定义模型。
2.2 Gradient Reduction
2.2.1 A Native Solution
借助 PyTorch autograd engine 支持提供自定义 backward hooks。朴素实现 hook 流程:
- 扫描 local model 的每个参数,并提取对应的梯度;
- 使用
AllReduce获取每个梯度在所有 ranks 上的均值; - 将均值结果梯度写回每个参数的梯度。
朴素实现的性能问题:
- 在每个参数梯度的小数据集上发起集合通信,性能很差。
- 梯度计算与同步完全顺序进行,未充分利用计算/通信资源提供的 overlap 机会。
2.2.2 Gradient Bucketing
Motivation:大数据量下集合通信的性能更高。如下图所示:
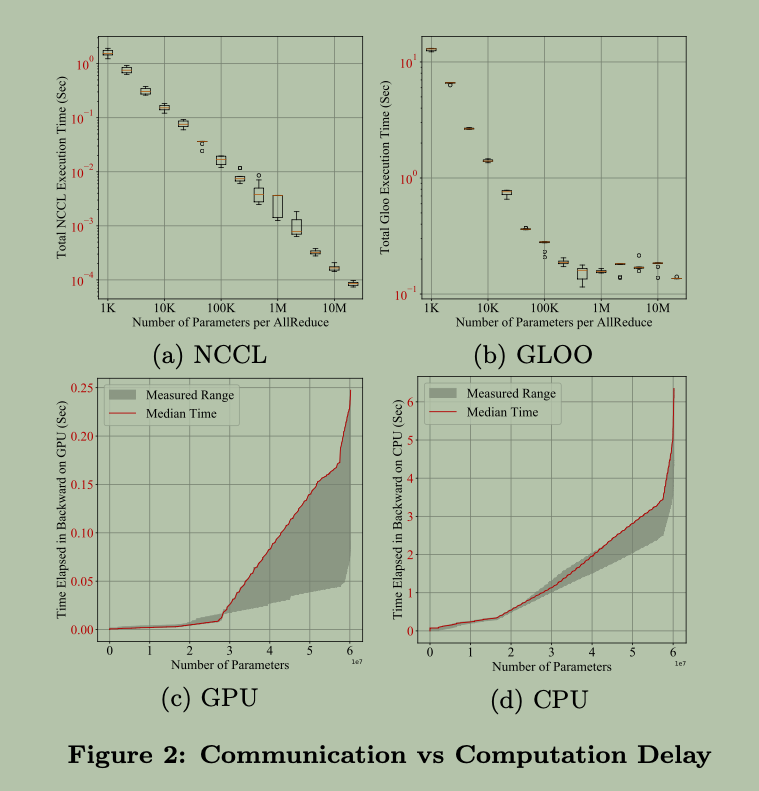
- 每个参数的平均 AllReduce 耗时随着一次 AllReduce 操作的参数梳理呈减少趋势。
- Bucket 取值:
- 适当大,以充分利用集合通信带宽;
- 不能等于模型全部参数,否则 backward 计算与梯度同步完全串行进行。
2.2.3 Overlap Computation with Communication
Motivation:有了梯度分桶之后,通信不需要等待整个模型的 backward 完成,而是只需要等待 bucket 内的参数 backward 完成。具体实现方式:
- DDP 为每个梯度累加器(gradient accumulator)都注册了一个自动求导钩子(autograd hook)。
- 当对应的累加器更新完梯度后,该钩子就会被触发,并检查它所归属的梯度桶(bucket)。
- 如果同一桶内所有梯度的钩子都已触发完毕,最后一个被触发的钩子就会对该桶启动异步 AllReduce 操作。
注意点:
- 所有进程执行 AllReduce 的顺序必须一致,否则可能导致数据错误或进程
crash。
- PyTorch 解决方法:采用
model.parameters()的逆序作为分桶顺序。 - 近似解决方法,但足够简单且多数情况下有效。
- PyTorch 解决方法:采用
- 可能一次训练迭代只涉及到模型全部参数的一个子集,且不同迭代间子集不同。这可能导致
hook 等不到 backward 完成,造成 backward 执行 hang。
- PyTorch 解决方法:DDP 在前向传播结束时,从输出张量(output tensors)开始遍历自动求导图(autograd graph),以找出所有真正参与本次计算的参数。这些参与计算的张量就绪,就足以作为判断反向传播完成的充分信号。
- DDP 在前向传播结束时主动将那些未参与计算的参数标记为就绪(ready),从而避免无效等待剩余的参数梯度。
DDP 算法流程:
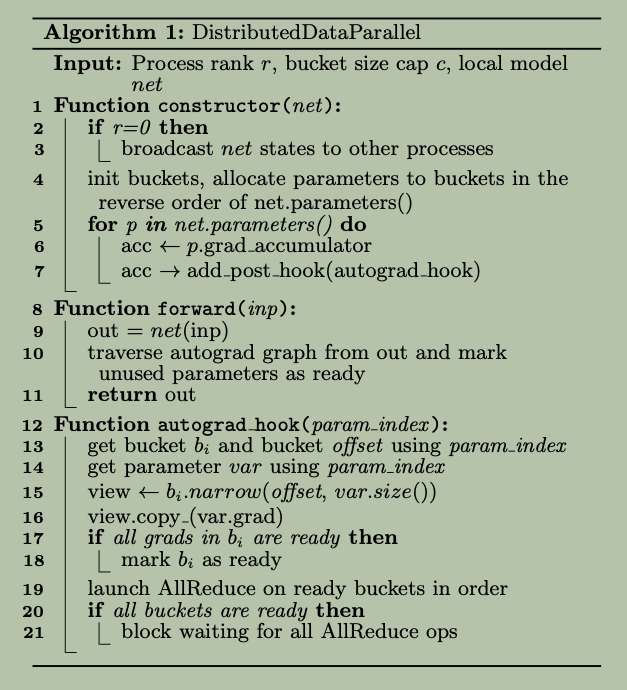
- 初始化
- 广播权重;
- 梯度分桶;
- 注册 backward 结束后的
autograd_hook函数。
- forward
- 运行 local model forward;
- 从输出 tensor 开始遍历计算图,标记未使用参数为 ready。
autograd_hook函数- 根据参数 index 获取 bucket index 和 bucket 内偏移量;
- 写参数梯度到 bucker offset;
- 如果当前 bucket 内所有梯度都 ready 了,标记 bucket 为 ready;
- 按照 ready bucket 顺序发起 AllReduce 通信;
- 通信完成后写 reduce 后梯度到参数梯度。
未使用参数处理:
- 问题:
- DDP 对所有参数(包括在 forward 时未使用的参数)都会拷贝 grad 并发起
AllReduce 通信写结果到参数
.grad,导致优化器无法识别一个参数是否真正参与了 forward 计算。 - 精度退化隐患:许多现代优化器(如带动量 Momentum 的
Adam/SGD)会根据“梯度是否存在”来决定是否更新动量值。如果某个参数本轮被跳过了(没有计算梯度),但
DDP 依然强行去改写了它的
.grad,优化器就会误以为它参与了计算并错误地更新动量状态,从而导致模型训练精度出现退化(Accuracy Regressions)。
- DDP 对所有参数(包括在 forward 时未使用的参数)都会拷贝 grad 并发起
AllReduce 通信写结果到参数
- 解决方法:全局位图(Global Bitmap)与额外 AllReduce
- 本地位图记录:每个 Worker 在本地维护一个 Bitmap(位图),记录本地有哪些参数参与了本轮计算。
- 发起额外的 AllReduce:在梯度同步前,额外发起一次全网 Bitmap 的 AllReduce 操作,汇聚计算出全局未使用的参数(Globally Unused Parameters。
- 精确避让:对于全局真正未使用的参数,DDP
会完全不去触碰其
.grad字段,从而将“无梯度”信号原封不动地传递给优化器。
DDP 执行流程示意图:
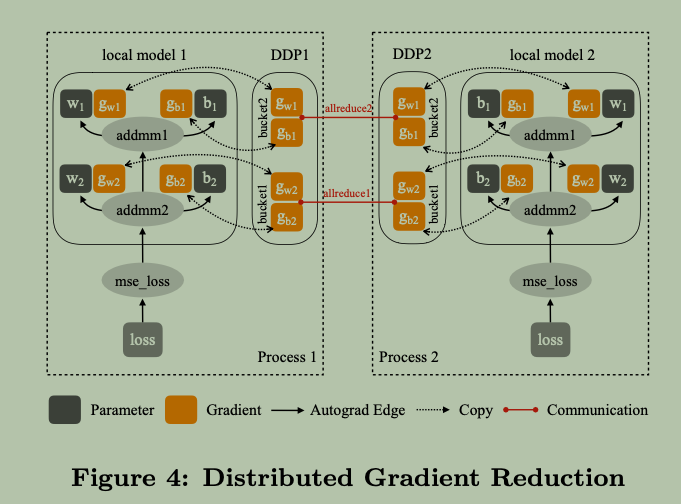
2.2.4 Gradient Accumulation
Motivation:减少 AllReduce 通信次数,不在每次训练迭代都发起 AllReduce 通信,而是每 \(n\) 次本地梯度累加后,发起一次全局梯度同步。
实现方式:引入专门的显式控制接口——no_sync 上下文管理器
- 开关标志置位:当进入
with ddp.no_sync():作用域时,DDP 会在内部置位一个开关标志,并在forward()方法中读取该标志。 - 禁用 DDP 钩子:在
no_sync模式下,DDP 挂载到 Autograd Engine 上的所有 C++ 钩子(即触发异步 AllReduce 的autograd_hook)均被暂时禁用。反向传播仅在本地将梯度累加到.grad中,不触发任何网络通信。 - 未用参数位图累积:全局未使用参数的信息会继续在 Bitmap 中进行累积,留到下一次真实发起通信时统一结算。
- 走出作用域同步:当走出
no_sync作用域后执行下一次backward()时,DDP 钩子重新恢复生效,将之前所有微批次累积的总梯度一次性发起全局 AllReduce 操作。
示例代码:
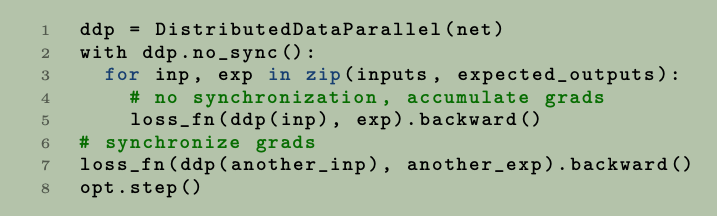
- 前 \(n-1\) 次迭代,使用
no_sync()上下文管理器封装,禁止 AllReduce,仅本地梯度累积; - 第 \(n\) 次迭代,在上下文管理器之外,进行梯度 AllReduce。
2.3 Collective Communication
DDP 需要使用 AllReduce 通信原语。PyTorch 基于 NCCL、Gloo 等通信库,封装统一的 ProcessGroup 接口。DDP 基于 ProcessGroup 实现,允许底层通信实现方式的替换。
一些实现细节:
- ProcessGroup 初始化:
- Rendezvous 服务:分布式集群启动时,各个 Worker
的启动时间存在微小差异。Rendezvous(如基于 TCP
或共享文件系统的注册中心)扮演了“集合点”的角色。只有当所有
WORLD_SIZE个进程都向 Rendezvous 报到完毕后,ProcessGroup的通信拓扑和 Ring 环才会被正式构建建立。
- Rendezvous 服务:分布式集群启动时,各个 Worker
的启动时间存在微小差异。Rendezvous(如基于 TCP
或共享文件系统的注册中心)扮演了“集合点”的角色。只有当所有
- NCCL backend 实现细节:
- 默认流 vs 通信流:PyTorch 前向/反向传播的 CUDA Kernel 默认提交给 CUDA 的 Default Stream(主流) 执行。
- 计算与通信解耦:NCCL
ProcessGroup内部维护了独立的通信 CUDA Stream。当反向传播在 Default Stream 计算完梯度的瞬间,通信命令被异步提交到通信 Stream。由于两个 Stream 在硬件级别由不同的 CUDA 硬件队列调度,通信与下一个算子的计算可以在 GPU 上并行重叠(Overlap)执行,完全不会阻塞主流计算。
3. Implementation
基于 PyTorch v1.5.0 版本介绍。
3.1 Python Front-end
几个实现细节:
- 可配置参数(Configurable Knobs):
process_group:允许用户指定特定的进程组实例来运行 AllReduce,避免与全局默认进程组(Default Process Group)产生混淆或冲突。bucket_cap_mb:控制 AllReduce 梯度分桶的大小上限(默认值为 25MB),开发者可根据具体模型规模与网络带宽微调该参数以优化训练速度。find_unused_parameters:布尔开关,用于控制 DDP 是否需要在前向传播中遍历 Autograd 图来自动检测并标记未参与计算的参数。
- 模型设备亲和性(Model Device Affinity):
- 对于单块 GPU 装不下的超大模型,开发者通常会将模型的不同层切分放置在同一个节点内的不同 GPU 上(即单进程多设备模型)。
- DDP 对这种多设备放置(Multi-device Model)提供了原生兼容。
- 当传入的
device_ids参数为None或空列表[]时,DDP 会自动检查模型的设备分布并完成配置,将这个跨多卡的模型视作一个统一的整体来进行管理与梯度同步。
- 模型缓冲区(Model Buffers):
- 除了模型参数外,许多网络层(如
BatchNorm)还需要维护一些不参与求导但随训练更新的内部状态(称为 Buffer,如running_mean和running_var)。 - Rank 0 广播:为了保证各节点间的 Buffer
严格一致,DDP 以 Rank 0
进程为权威(Authority)。在前向传播(
forward)开始前,DDP 会自动将 Rank 0 的 Buffer 值广播给所有其他进程。 - 与 no_sync
的协同:在开启
no_sync(梯度累积)模式时,DDP 会通过标志位控制 Buffer 广播的时机,仅在下一次即将真正发起全局通信的前向传播前才执行 Buffer 广播,从而避免在本地累积阶段产生不必要的广播开销。
- 除了模型参数外,许多网络层(如
3.2 Core Gradient Reduction
核心代码:reducer.cpp
,主要由 4 个组件构成:
- 参数到桶映射(Parameter-to-Bucket Mapping):
- 设备亲和性 (Device
Affinity):在每次反向传播中,梯度张量需要先从参数拷贝到对应的桶内存区,AllReduce
完成后再将平均梯度拷贝回
.grad。为了极大化显存内拷贝(D2D Memcpy)速度,梯度桶总是建立在与其关联参数相同的设备上。如果模型横跨多块 GPU,DDP 会严格按设备亲和性分组,确保同一个桶内的所有参数都在同一块 GPU 上。 - 通信发射逆序:按照
model.parameters()的逆序将参数指派给各个桶,并以此顺序发射通信。这一逆序尽可能逼近反向传播求导的真实顺序,从而最大化计算与通信的重叠效率。
- 设备亲和性 (Device
Affinity):在每次反向传播中,梯度张量需要先从参数拷贝到对应的桶内存区,AllReduce
完成后再将平均梯度拷贝回
- 自动求导钩子(Autograd Hook):
- 入口点与安装:Autograd Hook 是 DDP 介入反向传播的物理入口。在构造函数中,DDP 会遍历模型中的所有参数,获取每个参数对应的梯度累加器(Gradient Accumulator),并向其注册相同的 post-hook 回调函数。
- 待处理计数器 (Pending Count):由于梯度求导就绪的实际顺序存在不确定性,DDP 为每个梯度桶维护了一个待处理梯度计数器(Pending Count)。
- 递减与复位:每当某个参数的梯度算完并累加完成后,对应 post-hook 被触发并递减该桶的 Pending 计数;当计数归零时,说明该桶内所有梯度均已就绪,DDP 随即标记该桶 ready 并准备触发 AllReduce。在前向传播开始时,DDP 会重置每个桶的 Pending 计数。
- 桶 AllReduce(Bucket AllReduce):
- 性能瓶颈与折衷:Bucket AllReduce 是 DDP
中最主要的通信开销来源。
- 一方面,将更多梯度打包进同一个桶可以显著摊销通信开销;
- 另一方面,过大的桶会导致等待首个通信启动的前置时间(Lead Time)变长。
- 默认阈值:PyTorch 将默认的桶上限设为 25MB,开发者可以根据具体模型的参数量与物理网络带宽进行调整。
- 性能瓶颈与折衷:Bucket AllReduce 是 DDP
中最主要的通信开销来源。
- 全局未使用参数(Globally Unused Parameters):
- 共享 CPU 位图 (CPU Bitmap):DDP 在本地维护一个记录参数参与状态的位图(Bitmap)。为了避免为每个更新都单独发射 CUDA Kernel,整个模型的所有参数构成一个位图,并且该位图保存在 CPU 内存中。
- GPU 异步拷贝与通信:由于某些通信后端(如
ProcessGroupNCCL)不支持在 CPU 张量上直接运行 AllReduce,DDP 会在首个模型参数所在的 GPU 上额外维护一份设备位图(Device Bitmap)。通信前,通过非阻塞拷贝将 CPU 位图异步传输到 GPU 上,随后发起一次额外的 AllReduce 来搜集全局位图。
4. Discussion
4.1 Lessons Learned
提升 DDP 训练/通信速度的一些经验:
- 通信后端优先选择 NCCL:在绝大多数 GPU 分布式场景下,NCCL 的传输吞吐和性能均显著优于 Gloo,应作为优先考虑的底层通信后端。
- 梯度分桶大小(Bucket Size)需折衷调优:过小或过大的分桶都会损害通信性能。最优桶大小通常介于两者之间,且随模型规模的增长呈亚线性(Sub-linear)增长。
- 跨节点/跨机器资源分配避坑:当跨节点(Inter-node)的网络带宽远低于节点内(Intra-node,如
NVLink)的带宽时,跨机器扩展会导致显著的性能衰减。建议将单 DDP
进程组尽量控制在同一台机器内;若确实需要超大规模扩展,可结合
no_sync(跳过同步)来缓解跨节点带宽瓶颈。
4.2 Future Improvements
- 动态梯度顺序预测 (Gradient Order Prediction)
- 现状与局限:DDP 目前在构造函数中通过
model.parameters()的静态逆序来确定分桶策略,但在复杂动态图中可能产生顺序错位。 - 优化思路:利用 Autograd Hook 在运行时动态追踪反向传播的实际求导顺序,并据此定期/低频地重新调整参数到桶的映射。
- 现状与局限:DDP 目前在构造函数中通过
- 跨节点层丢弃/随机深度兼容 (Layer Dropping)
- 现状与局限:在 Transformer 等模型中使用层丢弃(Layer Dropping/Structured Dropout)时,由于 DDP 的分桶是静态预先分配的,即使前向传播跳过了某些层,网络上依然传输着相同大小的固定桶,无法节省通信带宽。
- 优化思路:
- 动态修改参数到桶的映射;
- 或者将分桶粒度提升至“层级(Layer-level)”,使所有 Worker 通过相同随机种子或主节点广播,实现整个桶级别的同步跳过。
- 梯度自适应压缩 (Gradient Compression)
- 现状与局限:DDP 始终使用与参数相同的精度(如 FP32/FP64)传输梯度,在模型接近收敛时显得较为冗余。
- 优化思路:引入自适应梯度压缩机制,根据训练阶段动态降低梯度传输精度(如量化为 INT8),甚至采用更激进的 1-bit SGD 方案,在几乎不损失模型精度的前提下大幅削减网络通信量。
5. Conclusion
DDP 实现要点:
- gradient bucket
- 优点:
- 更高的通信吞吐。
- 允许 backward 计算与 AllReduce 梯度同步 overlap。
- 实现:
- 按
model.parameters()逆序分桶,匹配反向传播求导顺序。
- 按
- 优点:
- 梯度累积:除了多卡/跨机 DDP 训练,通过本地梯度累积减少通信开销。
- autograd hook 实现:
- forward 检测参数是否参与。
- backward 完成调用 hook 标记梯度 ready,bucket 内 ready 后,按 bucket 顺序发起通信。
- 全局位图(Global Bitmap):准确识别未参与参数,避免改写
.grad破坏优化器动量状态。
- 一些细节:
- 独立 CUDA Stream:通信与计算在不同硬件队列并行,互不阻塞。
- 轮询进程组(Round-Robin):多 ProcessGroup 轮询发射通信,打破单进程组带宽瓶颈。