LightSeq2: Accelerated Training for Transformer-based Models on GPUs
- LightSeq2: Accelerated Training for Transformer-based Models on GPUs
- arXiv 提交日期:12 Oct 2021
- GitHub:https://github.com/bytedance/lightseq
- 作者:
摘要
基于 Transformer 的神经网络模型已被广泛应用于许多人工智能领域。训练这些模型非常昂贵,因为它不仅消耗巨大的 GPU 资源,还需要漫长的训练时间。由于像句子这类典型数据具有变长特性,且 Transformer 的计算模式比卷积神经网络更为复杂,因此加速其训练极具挑战性。现有的加速系统要么仅关注模型推理,要么仅针对类 BERT 的 Encoder 模型进行优化。在本文中,我们提出了 LightSeq2,这是一个用于在 GPU 上加速通用 Transformer 家族模型训练的系统。我们提出了一系列量身定制的 GPU 优化技术,以匹配 Transformer 模型的特定计算流和内存访问模式。LightSeq2 支持多种模型架构,包括 BERT(纯 Encoder)、GPT(纯 Decoder)、Transformer(Encoder-Decoder)以及 Vision Transformer。我们在多种模型和基准测试上进行的实验表明,LightSeq2 在不同 GPU 上均始终比先前的系统快 1.4 到 3.5 倍。特别是在大型公开机器翻译基准测试(WMT14 英德)上,与现有系统相比,它实现了 308% 的训练加速效果。
1. Introduction
问题与背景
- 随着 Transformer 模型规则增大,训练/推理成本增加。
- 已有 Transformer 加速库仅针对推理或者 BERT(encoder-only)模型设计。
- 加速 Transformer 训练额外的挑战:
- 训练框架除了 forward,还需要支持高效的 kernel 实现 backward 梯度计算。而 高效的 backward kernel 的实现要比 forward 更加复杂。
- trainer(optimizer)的参数更新过程需要加速。
- 训练框架需要不同于推理框架的内存管理/优化技术。
本文提出的 Solution
提出了 LightSeq2 System,面向 Transformer 模型的训练/推理加速。
三项关键加速技术:
- layer-specific kernels to increase GPU utilization
- fusing small kernels.
- rewriting kernels with dependencies among other parallelism enhancing techniques.
- fine-grain mixed-precision trainer
- accelerate the trainer (i.e., parameter optimizer) by employing batched update on reduced-precision parameters rather than many individual updates on full-precision parameters.
- an improved strategy for efficient GPU memory management
- propose a memory manager that, aware of the Transformer structure, can recycle the space of tensors unused in backward pass to reduce peak memory consumption and avoid excessive allocation/release calls.
2. The LightSeq2 System
LightSeq2 主要有 4 项优化技术,下面详细介绍。
2.1 Computational Graph Optimizations
2.1.1 Transformer Layers
Transformer Layer 需要的算子分类如下:
- GEMM
- Non-GEMM
- Elementwise:Dropout、ReLU、Reshape 等
- Reduce:LayerNorm、Softmax 等
优化(Kernel Fusion)后的 Transformer 计算图:
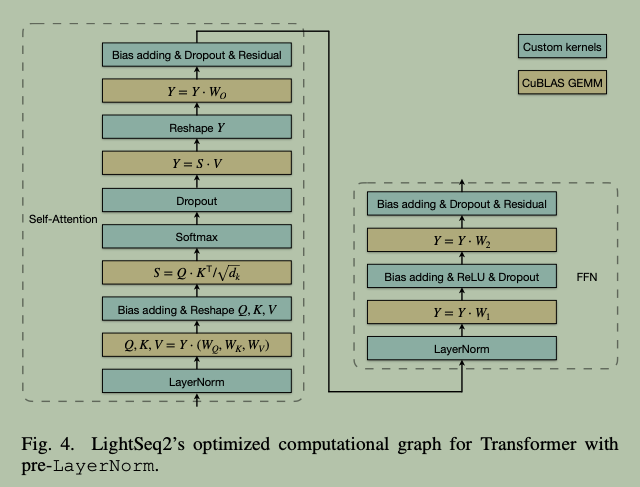
- 例子:
- Self-Attention 最后一步的 Bias Add & Dropout & Residual Add 三个 element-wise 操作 fused 成一个 kernel。
2.1.2 Embedding Layer
forward
给定:
- 词嵌入查找表(Token Embedding Lookup Table):\(E\)
- 位置嵌入查找表(Positional Embedding Lookup Table):\(P\)
- 词缩放因子(Embedding Scale):\(s\)(例如在 Transformer 中常为 \(\sqrt{d_{model}}\))
对于索引为 \(w\)、位置索引为 \(p\) 的 Token,其最终的向量表示 \(v^{(w,p)}\) 计算公式为:
\[ v^{(w,p)} = \text{Dropout}(s \cdot E_w + P_p) \]
其中:
- \(E_w\) 表示从词表 \(E\) 中提取第 \(w\) 个词的向量。
- \(P_p\) 表示从位置表 \(P\) 中提取第 \(p\) 个位置的向量。
backward
设输入句子的长度为 \(l\),在前向传播过程中生成的 Dropout 掩码(Mask)为 \(m\)(其中 \(m^{(i)}\) 表示第 \(i\) 个位置的 Dropout 掩码)。
对于句子中出现的词 \(w\),在嵌入表 \(E\) 中对应的梯度 \(\nabla E\) 计算公式为:
\[ \nabla E = s \cdot \sum_{0 \le i \lt l: x_i = w} m^{(i)} \odot \nabla y^{(x_i, i)} \]
其中:
- \(\odot\) 表示按元素相乘(Element-wise Product)。
- \(\nabla y^{(x_i, i)}\) 表示损失函数 \(\mathcal{L}\) 对中间层输出 \(y\) 的偏导数 \(\frac{\partial \mathcal{L}}{\partial y}\)。
- \(\sum_{0 \le i \lt l: x_i = w}\) 表示遍历整句中所有出现词 \(w\) 的位置 \(i\),将这些位置传回的梯度进行累加。
在同一 Batch 或句子中,同一个词 \(w\) 可能会在不同位置多次出现,不同 GPU 线程在计算梯度时会尝试同时更新嵌入表 \(E\) 中 \(w\) 对应的同一行。
LightSeq2 在 CUDA Kernel 中使用了
atomicAdd操作:通过并行化 atomicAdd
直接将各个位置计算出的梯度安全地累加回词嵌入表 \(E\) 中。
2.1.3 Criterion Layer
略,见课程 slides。
2.1.4 Layer-batched cross Attention
示意图如下:
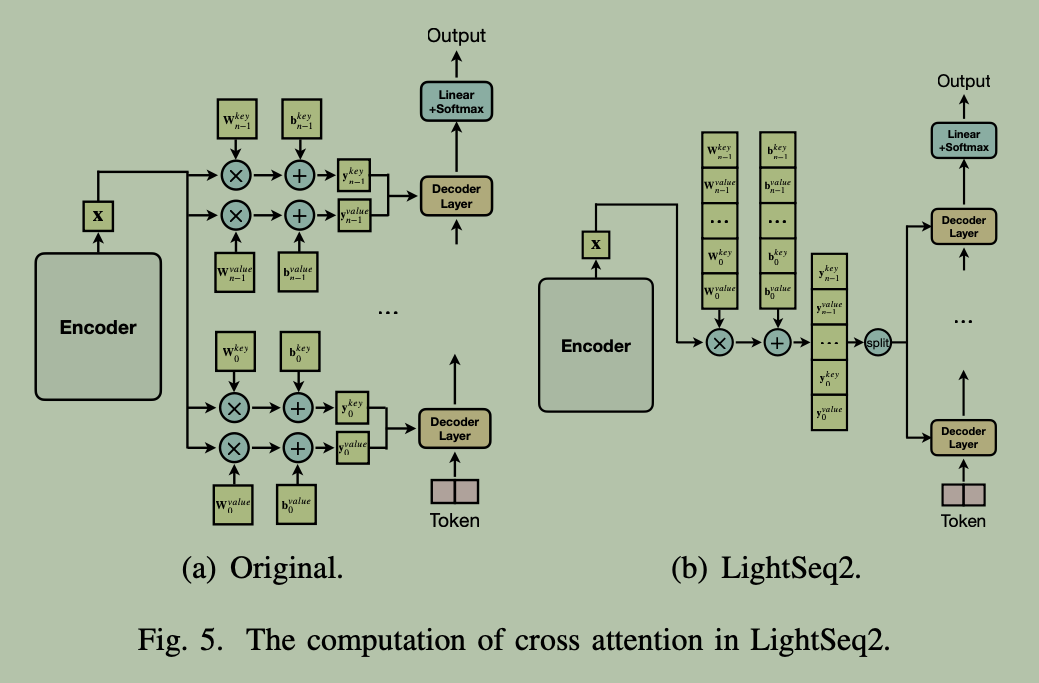
- 将 decoder 多层 key/value 计算合并为一次计算。
2.2 Dependent Reduction Rewriting
指 LayerNorm/Softmax 减少同步的实现方式。
略,见课程 slides。
2.3 Accelerated Mixed-Precision Update for Trainer
朴素混合精度训练实现方式和存在的问题:
- 实现方式:
- 为了加速训练,模型的参数(Parameters)和梯度(Gradients)均使用 FP16(半精度浮点数)存储。
- 为了保证数值精度,需要维护一份 FP32(单精度浮点数)的参数与梯度副本来保证更新精度。
- 问题:
- GPU 利用率低(频繁启动碎片化 Kernel):模型中包含大量独立的参数矩阵和梯度片段(如各个 Linear 层的 weights 和 biases)。在每个训练 Step 中,系统需要针对每一块参数和梯度分别启动 GPU Kernel 进行 FP16 与 FP32 之间的复制和更新,产生海量极短调用的 Kernel 开销。
- 显存开销冗余(Memory Footprint):额外保留一套完整 FP32 尺寸的参数和梯度副本,占据了巨大的 GPU 显存空间。
LightSeq2 优化实现:
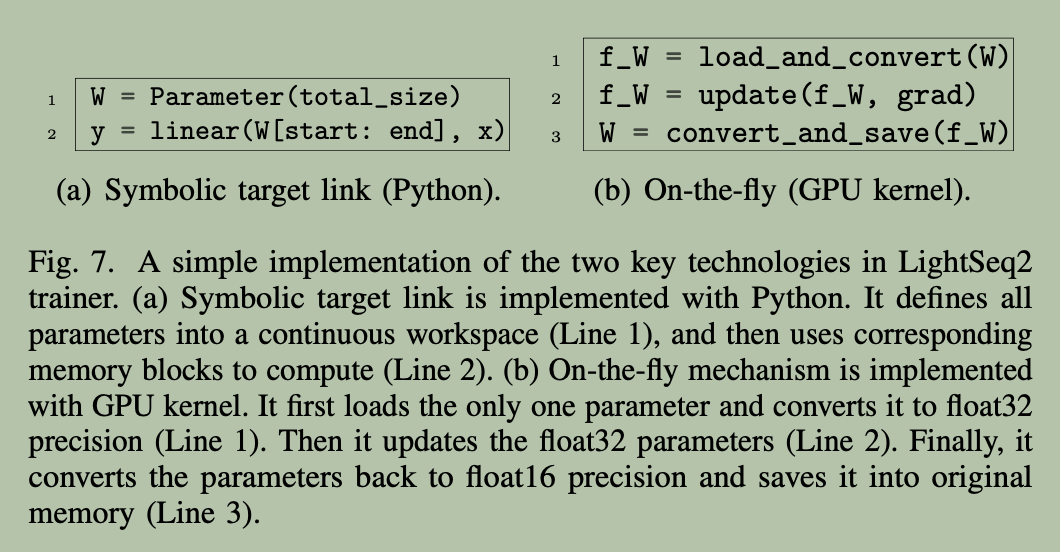
LightSeq2 通过 符号张量链接(Symbolic Tensor Linking) 和 On-the-fly 实时转换 两项技术联合解决了上述问题。
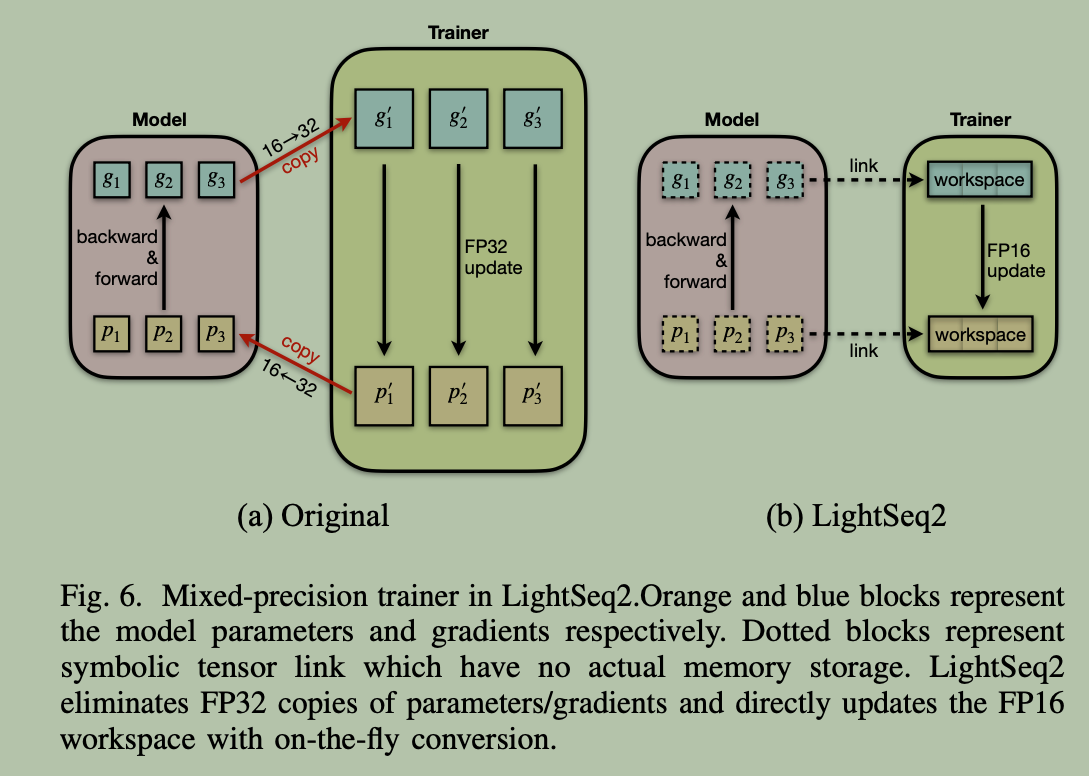
- 符号张量链接 (Symbolic Tensor Linking)
- 原理:在 Trainer 初始化阶段,LightSeq2
预先分配一块连续的 GPU 内存空间,称为
workspace。然后将模型中所有散乱的 FP16 参数与梯度按顺序复制/拼接到这块连续空间中,并将模型原有的参数指针重定向(Link)为该workspace中的相应切片(Fragments)。 - 优势:在后期的每个训练 Step 中,Trainer
只需要启动一次 GPU Kernel 就能完成对整个
workspace(即所有参数)的统一更新,避免了上千个碎片化 Kernel 的反复启动。
- 原理:在 Trainer 初始化阶段,LightSeq2
预先分配一块连续的 GPU 内存空间,称为
- On-the-fly 实时转换 (On-the-fly Conversion)
- 原理:不再在 GPU 显存中保存昂贵的 FP32 参数与梯度副本。
- 具体过程:
- Trainer 单次启动的 CUDA Kernel 直接从
workspace中读取 FP16 的参数和梯度数据到 GPU 寄存器(Registers)中。 - 在寄存器内部实时(On-the-fly)转换为 FP32 精度。
- 在寄存器中完成 FP32 级别的参数更新计算(如 Adam 算法)。
- 将更新后的结果在寄存器中实时转回 FP16,并直接写回
workspace的显存中。
- Trainer 单次启动的 CUDA Kernel 直接从
实现示意图:
2.4 Dangling-Tensor Aware Memory Manager
略,见课程 slides。
3. Usability Design
3.1 Software Architecture
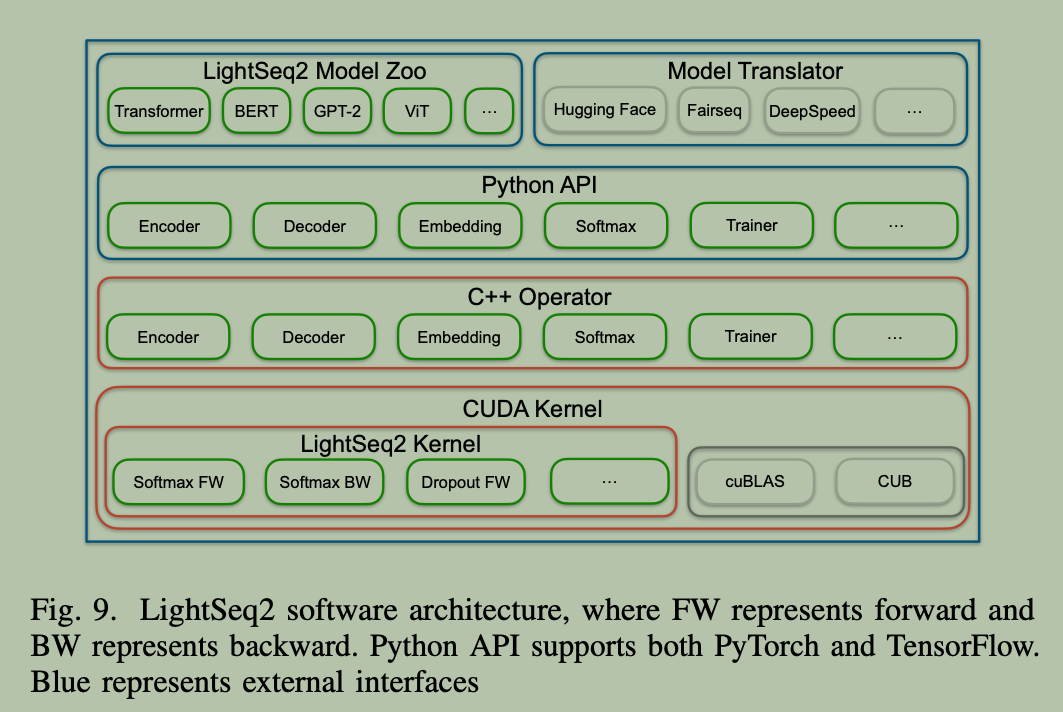
- 内核层
- CUDA kernel
- C++ Operator
- 用户 API 层
- Python API
- Model Zoo
- Model Translator
3.2 Interoperability
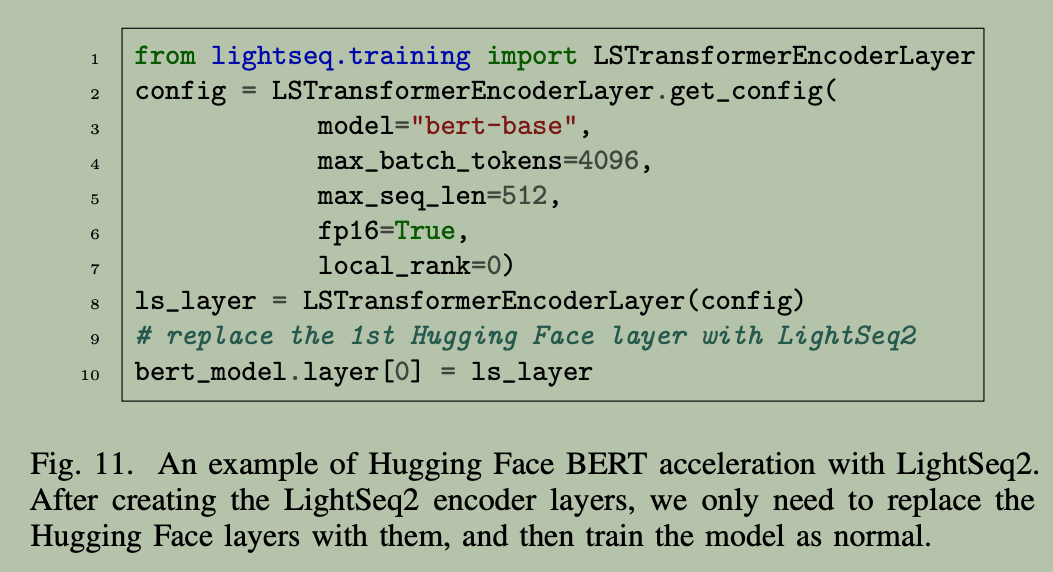
LightSeq2 is deeply integrated with mainstream training codebases, and users can use LightSeq2 for accelerated training without modifying the code.
3.3 Example Usage
4. Conclusion
- 自定义训练框架分层组织实现
- CUDA Kernel
- C++ Operator
- Python API
- Model Zoo
- Model Translator(CheckPoint)
- 常见 Transformer 优化技术
- Kernel Fusion
- Reduce inner kernel synchronization
- Memory Management Optimization
- Pre-allocate + symbol link
- reduce frequently alloc/free
- contiguous memory enable less kernel launch
- Memory Reuse
- Pre-allocate + symbol link