LLM Systems 22: Flash Attention: Optimizing Attention for Modern Hardware
0. Recap
之前课程主线:
- LLM 简介
- CUDA 编程基础
- 深度学习框架(自动求导)
- Transformer/Pre-trained LLM
- LLM 前后两个辅助组件:Tokenizer 与 Decoding
- Transformer 加速:Kernel Fusion & Mix-precision & Memory Management Optimization
- 支线(跳过):Guest Lecture:Google TPU/JAX 生态介绍
- 分布式训练技术:
- 基本概念与集合通信原语
- DDP
- TP
- PP
- MoE:限制 FLOPs 前提下提升模型参数效率 & EP 专家并行
- ZeRO:内存效率优化
- 量化与微调:
- 基本概念:int8 & Absmax quant & Zero-point quant & Layer-wise quant
- GPTQ
- LoRA & QLoRA
接下来几课 Guest Lecture 居多,介绍一些LLM 实际落地面临的问题和解决方案,包括:
- 高效 Attention 算子实现:FlashAttention
- 推理框架:SGLang & vLLM
- RL 训练框架:ReaLHF
- PD 分离:DistServe
- KV Cache 存储与管理:LMCache
- 异构硬件上 LLM serving:Mooncake & kTransformer
- LLM 应用/Serving 完全流程:Lecture 30 App Stack and Model Serving
- Beyond LLM itself
- AI Compiler: Triton & JAX
- RAG: RAG
- Nearest Vector Search for Embeddings: HNSW
- Multimodal LLMs: Flamingo
- Efficient Streaming Language Models with Attention Sinks: Attention Sink
1. Motivation: Modeling Long Sequences
- 现实世界的任务建模需要长上下文(序列长度)
- 问题:
- 朴素的 Attention 实现在长上下文时效率低下:
- 需要存储中间结果矩阵,显存占用与序列长度呈平方增长。
- 来回的 HBM 读写,效率受显存带宽限制。
- 朴素的 Attention 实现在长上下文时效率低下:
2. Background
2.1 Attention
设序列长度为 \(N\) ,每个 Attention Head 的维度为 \(d\) ,则 Attention 计算过程如下图所示:
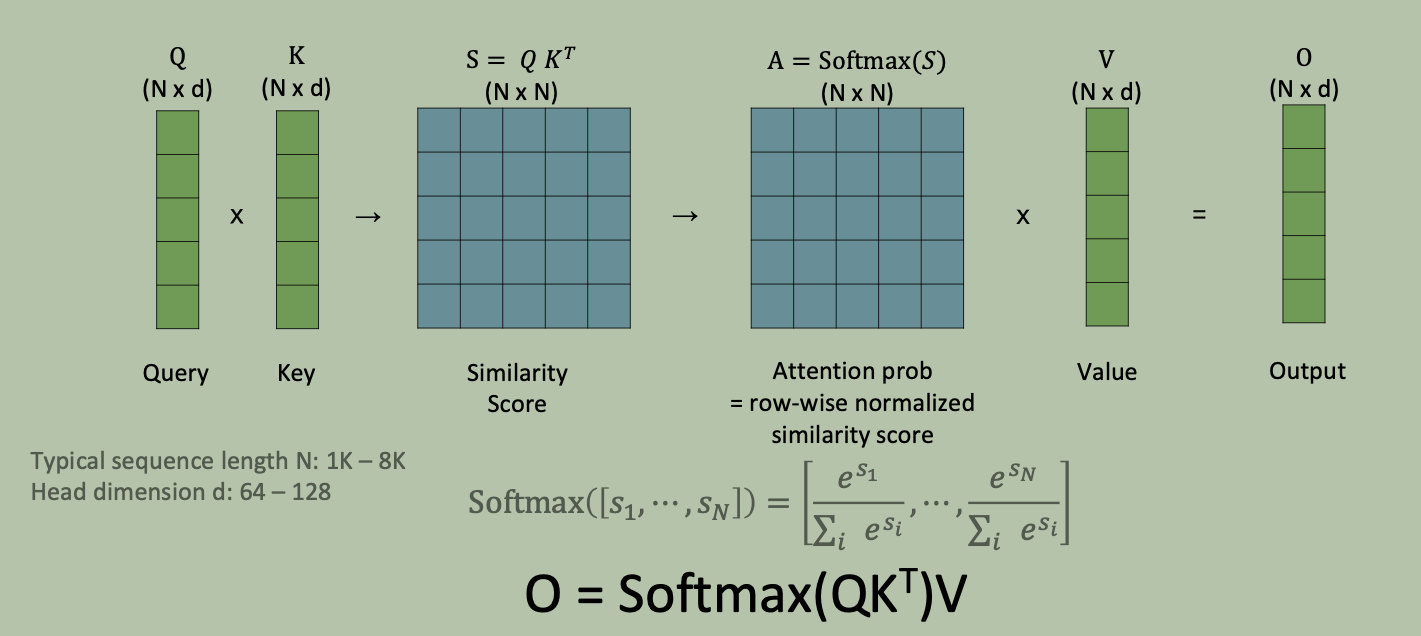
- \(QK^T\) 计算得到相似度得分矩阵 \(S\);
- 对 \(S\) 每一行进行 Softmax 得到注意力概率矩阵 \(A\);
- \(AV\) 计算得到最终输出矩阵 \(O\) 。
Attention is Bottlenecked by Memory Reads/Writes
- 朴素 Attention 实现需要来回读写 \(S\) 和 \(A\) 矩阵,kernel 效率受 HBM 带宽限制。
2.2 GPU Compute Model & Memory Hierarchy
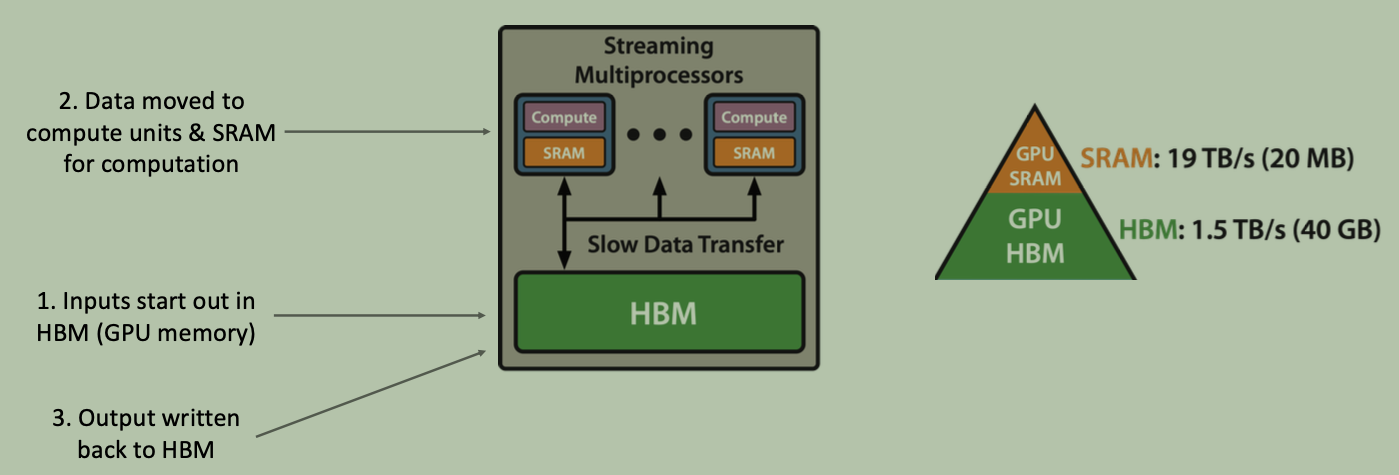
- SRAM 带宽远高于 HBM 带宽。
- Motivation:
- 利用存储层次的异构性来加速,将 \(S\) 和 \(A\) 都通过 tile 只在 SRAM 中读写,避免写入 HBM。
- 按块计算(tile)能够减少 HBM 读写,但同时也带来了新的挑战:
- 如何在没有完整输入的情况下计算 softmax 归一化项?
- 重构算法,逐个 tile 从 HBM 加载数据到 SRAM 计算 attention。
- 如何在没有存储 attention score 矩阵的情况下进行 backward 计算?
- 重计算:backward 时重新计算 attention score 矩阵,而不是存储。
- 如何在没有完整输入的情况下计算 softmax 归一化项?
3. Flash Attention
3.1 Forward
1st Attempt: Computing Attention by Blocks
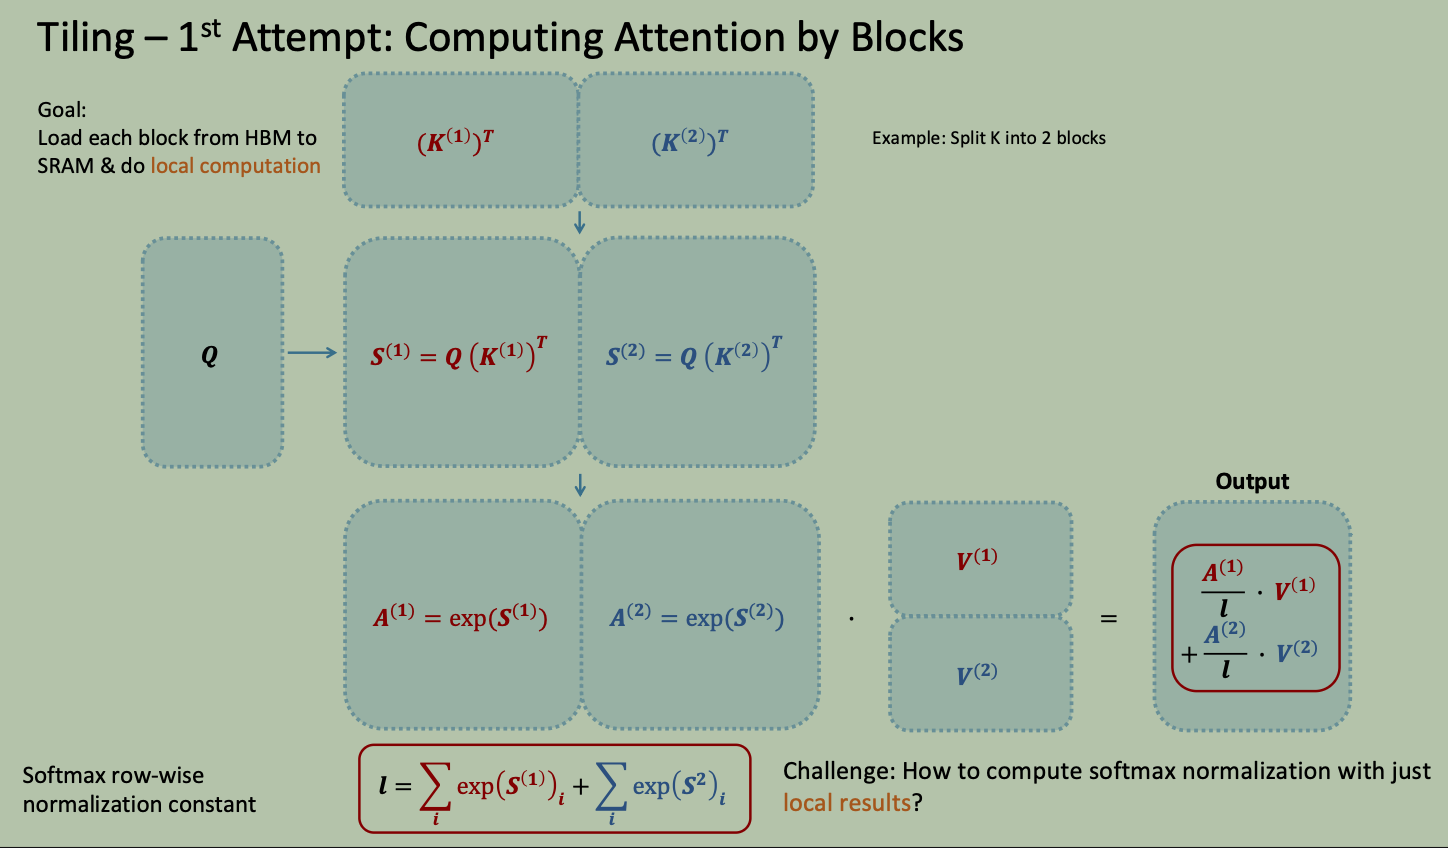
- 对矩阵 \(K^T\) 和 \(V\) 沿着序列长度方向进行分块,每次计算一个 tile;
- 问题:
- 每个 tile 根据自己的局部相似度得分计算得到的归一化项,如何在两个 tile 间进行转换,得到真正的正确的全局归一化项?
2nd Attempt: Computing Attention by Blocks, with Softmax Rescaling
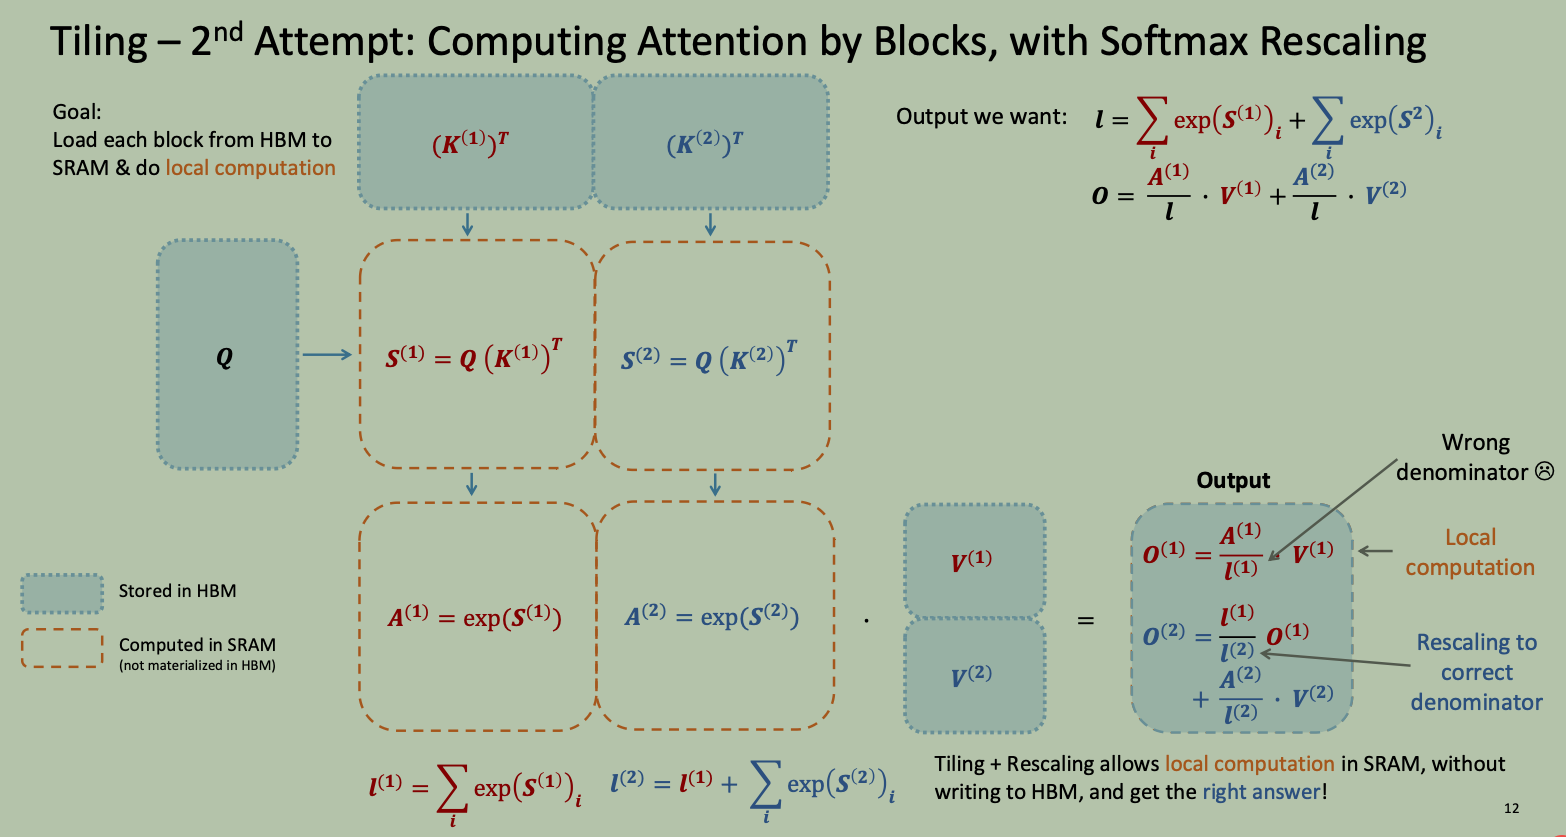
- 核心思想:
- 允许局部先用“局部分母”计算出一个暂存的局部输出,在新 Block 读入时通过动态缩放因子(Rescaling Factor)修正历史输出。
- 阶段 1:处理 Block 1
- 在 SRAM 中算出 Block 1 的局部分母:\(l^{(1)} = \sum_i \exp(S^{(1)})_i\) ;
- 先用局部分母计算出 局部输出:\(O^{(1)} = \frac{A^{(1)}}{l^{(1)}} \cdot V^{(1)}\) 。
- 阶段 2:读入 Block 2 并进行动态 Rescaling 校正
- 读入 Block 2 后,更新归一化分母:\(l^{(2)} = l^{(1)} + \sum_i \exp(S^{(2)})_i\) ;
- 输出校正与叠加公式: \(O^{(2)} = O^{(1)} \cdot \left( \frac{l^{(1)}}{l^{(2)}} \right) + \frac{A^{(2)}}{l^{(2)}} \cdot V^{(2)}\) 。
- 数学等价推导:
- 由于 \(O^{(1)}\) 原本的分母是 \(l^{(1)}\),乘以缩放系数 \(\frac{l^{(1)}}{l^{(2)}}\) 之后,相当于把旧输出 \(O^{(1)}\) 的分母动态“矫正”为了新的全局分母 \(l^{(2)}\) 。这实现了将大 Softmax 拆解为多个小 Softmax 增量缩放叠加,使得所有计算都能在片上 SRAM 中完成,完全无需将庞大的中间矩阵写回 HBM。
注意:上述 slides 推导为了简化,将分子作为直接的 \(\exp (S)\) , 实际计算时分子 exp 计算需要减去局部最大值,推导过程如下:
假设我们有两个块 Tile 1 和 Tile 2:
- 处理 Tile 1 时:
- 局部最大值:\(m^{(1)} = \max(S^{(1)})\)
- 局部未归一化分母:\(d^{(1)} = \sum e^{S^{(1)} - m^{(1)}}\)
- 局部暂存输出(未归一化):\(\mathbf{o}^{(1)} = \sum e^{S^{(1)} - m^{(1)}} V^{(1)}\)
- 当 Tile 2 读入时:
- Tile 2 的局部最大值:\(m^{(2)} = \max(S^{(2)})\)
- 新的全局最大值:\(m^{(\text{new})} = \max(m^{(1)}, m^{(2)})\)
由于基准最大值由 \(m^{(1)}\) 变成了更大的 \(m^{(\text{new})}\),之前 Tile 1 算好的指数项 \(e^{S^{(1)} - m^{(1)}}\) 的基准发生改变,也需要进行分子的 scale! 根据指数恒等式:
\[ e^{S^{(1)} - m^{(\text{new})}} = e^{(S^{(1)} - m^{(1)}) + (m^{(1)} - m^{(\text{new})})} = e^{S^{(1)} - m^{(1)}} \cdot \mathbf{e^{m^{(1)} - m^{(\text{new})}}} \]
为了将旧输出 \(\mathbf{o}^{(1)}\) 对齐到新的基准 \(m^{(\text{new})}\) 和新的全局分母 \(d^{(\text{new})}\),真正的缩放因子 \(\alpha\) 必须由两部分相乘组成:
\[ \mathbf{o}^{(\text{new})} = \mathbf{o}^{(1)} \cdot \underbrace{\left[ \frac{d^{(1)} \cdot \mathbf{e^{m^{(1)} - m^{(\text{new})}}}}{d^{(\text{new})}} \right]}_{\text{真实的完整 Rescaling 缩放因子 } \alpha} + \sum \frac{e^{S^{(2)} - m^{(\text{new})}}}{d^{(\text{new})}} V^{(2)} \]
这个完整的缩放因子 \(\alpha\) 包含了两个维度的修正:
- \(e^{m^{(1)} - m^{(\text{new})}}\)(基准对齐因子):因为 \(m^{(\text{new})} \ge m^{(1)}\),所以 \(m^{(1)} - m^{(\text{new})} \le 0\)。这个指数衰减因子负责将旧的指数值等比例“缩小”,对齐到更大的新最大值上。
- \(\frac{d^{(1)}}{d^{(\text{new})}}\)(分母归一化因子):即上述图片展示的部分,负责将旧的分母修正为包含 Tile 2 后的新全局分母。
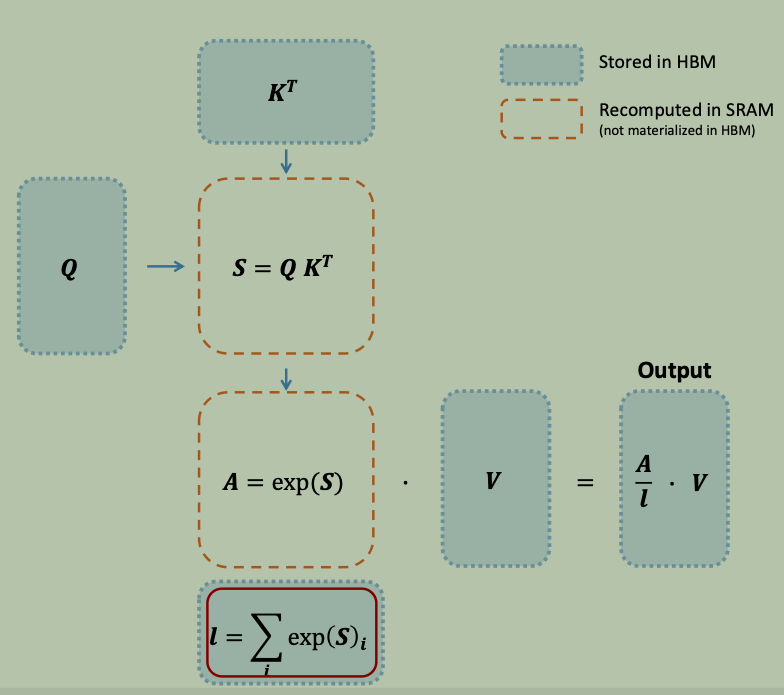
3.2 Backward: Recomputation
- 朴素实现:保存 \(A\) 矩阵用于 backward 时计算 \(Q,K,V\) 梯度;
- FlashAttention:
- 只保存每一行的最大值和 softmax 归一化项(即最大值 \(m\) 和归一化分母 \(l\) ,通常称为 LogSumExp/LSE);
- backward 时再次将输入 \(Q, K, V\) 按块载入片上 SRAM,配合保留的 \(O(N)\) 归一化常数,在 SRAM 片上动态重新计算出局部注意力矩阵 \(A\) 块,然后计算 Q/K/V 梯度。
示意图如下:
3.3 Evaluation
| 评估指标 | 传统 Standard Attention | FlashAttention (Recomputation) | 变化幅值与物理意义 |
|---|---|---|---|
| GFLOPs(计算量) | 66.6 | 75.2 | ↑ 13%(因为反向传播多算了一次前向的点积) |
| HBM 读写量(GB) | 40.3 GB | 4.4 GB | ↓ 9 倍(省去了 \(N \times N\) 中间激活值的 HBM 搬运) |
| 反向耗时 Runtime(ms) | 41.7 ms | 7.3 ms | ↓ 6 倍加速(运行时间大幅缩短) |
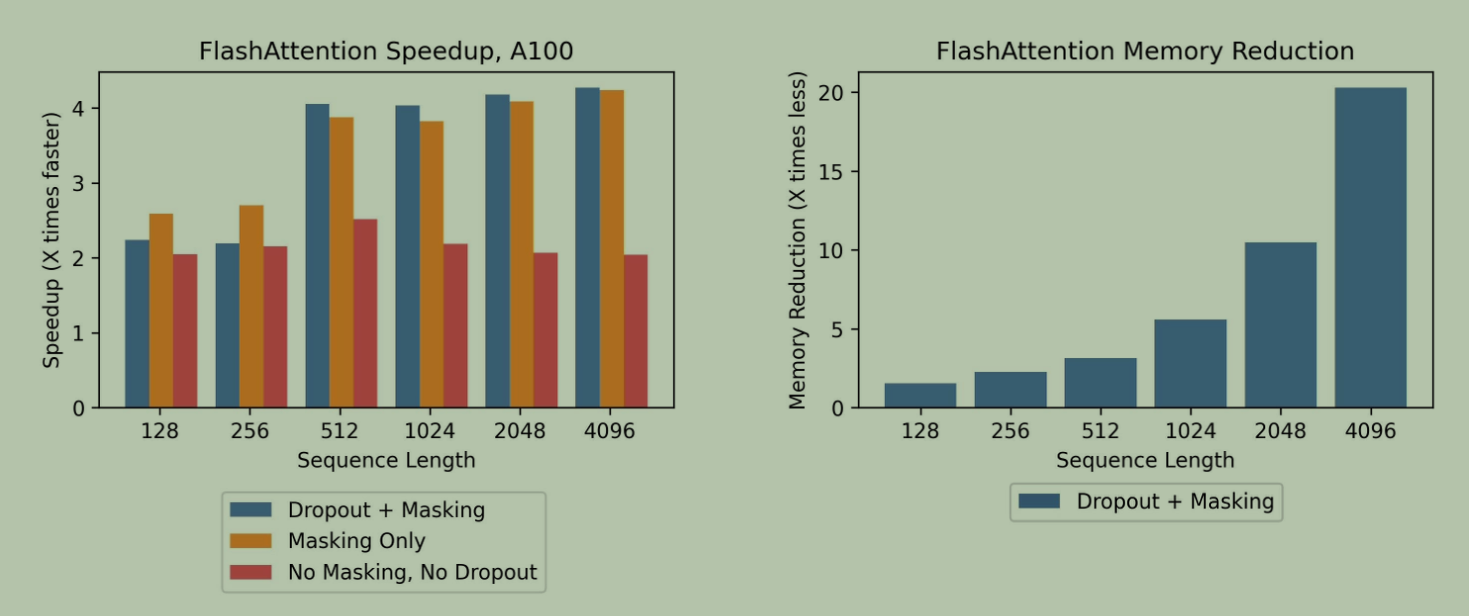
- 实现了 2~4 倍加速;10~20 倍内存占用减少。
4. Flash Attention for Modern Hardware
4.1 FlashAttention-3: Optimizing FlashAttention for Hopper Architecture
FA2 在 Hopper GPU 上存在的问题:
- FlashAttention-2 在 H100 上的硬件低效:FlashAttention-2 在 A100 GPU 上能达到约 70% 的理论硬件利用率,但在 H100 GPU 上却仅能达到 35%–40%。
- 瓶颈根源:Hopper 架构(H100)引入了翻倍的 Tensor Core 算力以及全新的硬件原语(WGMMA、TMA),但旧有的线程块与调度设计无法有效掩盖硬件的特殊函数单元(SFU)计算延迟与显存传输瓶颈。
4.1.1 New instructions on H100: WGMMA & TMA
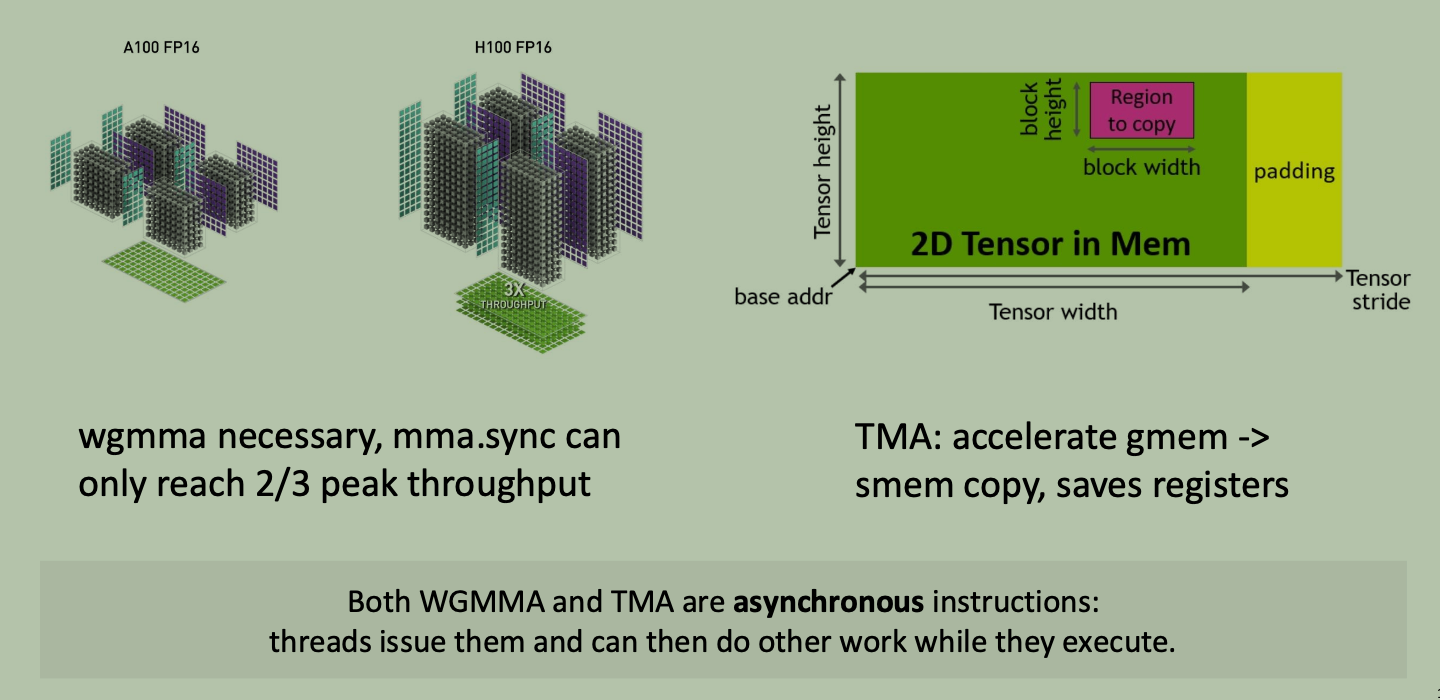
- WGMMA (Warp-Group Matrix
Multiply-Accumulate):Hopper 专属的 WarpGroup
级矩阵乘法指令。旧有的
mma.sync只能发挥 H100 理论峰值吞吐的 2/3,而 WGMMA 拥有更高的吞吐量,且属于异步指令。 - TMA (Tensor Memory Accelerator):硬件级的张量内存加速器,能在全局显存(HBM)与片上共享内存(Shared Memory / SMEM)之间实现高效的异步 2D/3D 张量数据传输,同时大幅省去了对寄存器的占用。
4.1.2 Asynchrony: Inter-warpgroup & Intra-warpgroup overlapping
- Motivation:
- 特殊函数单元(SFU,如
MUFU.EX2求指数)的算力远低于 Tensor Core。 - 示例说明:headdim 128, block size 128 x 128
- FP16 WGMMA: 2 x 2 x 128 x 128 x 128 = 8.4 MFLOPS, 4096 FLOPS/cycle -> 2048 cycles
- MUFU.EX2: 128 x 128 = 16k OPS, 16 OPS/cycle -> 1024 cycles
- 指数计算
MUFU.EX2占了 WGMMA 的 50% 周期。因此必须在 Tensor Core 跑 GEMM 时,并行让 SFU 计算 Softmax 指数。
- 特殊函数单元(SFU,如
Inter-warpgroup Overlapping of GEMM and Softmax
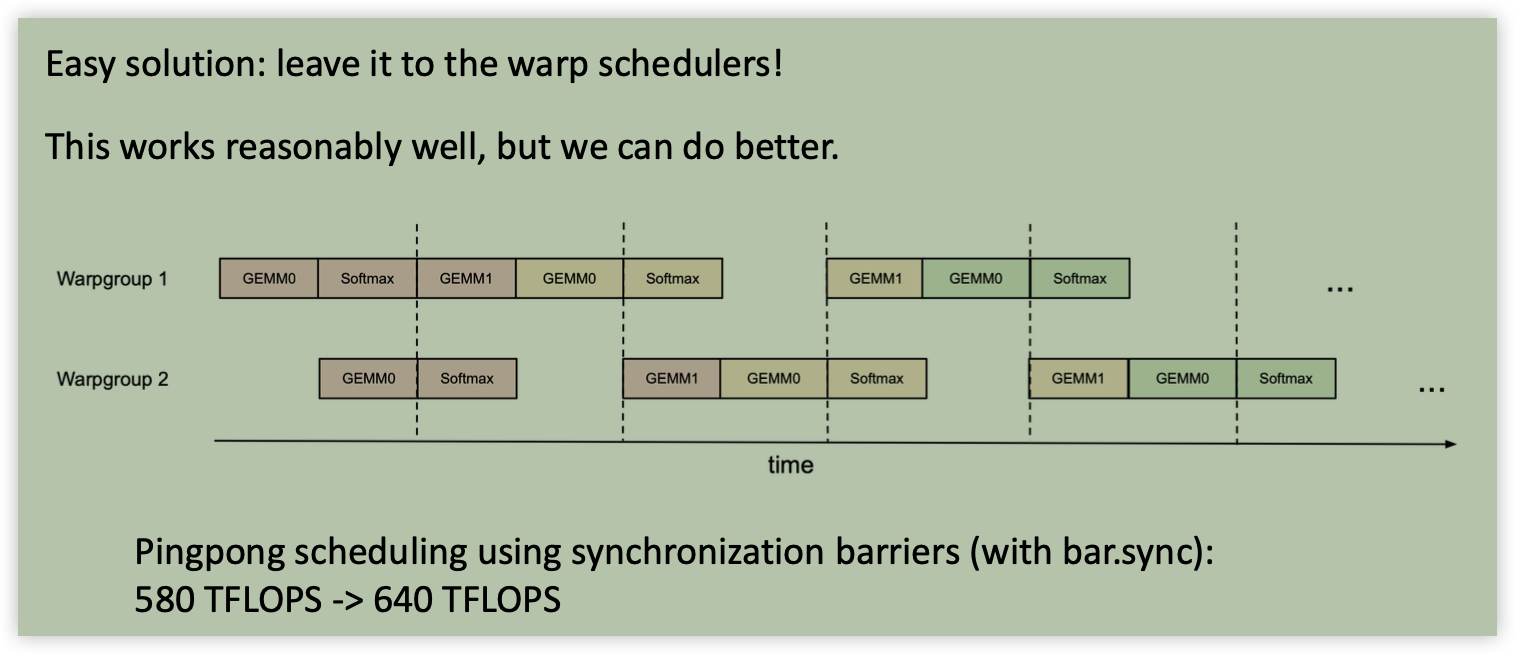
- Inter-warpgroup Overlapping(WarpGroup 间重叠 /
乒乓调度):使用 Warp Specialization(Warp
角色分工)与同步屏障(
bar.sync),让不同的 WarpGroup 呈乒乓交错状并行计算,将性能从 580 TFLOPS 提升至 640 TFLOPS。
Intra-warpgroup Overlapping of GEMM and Softmax
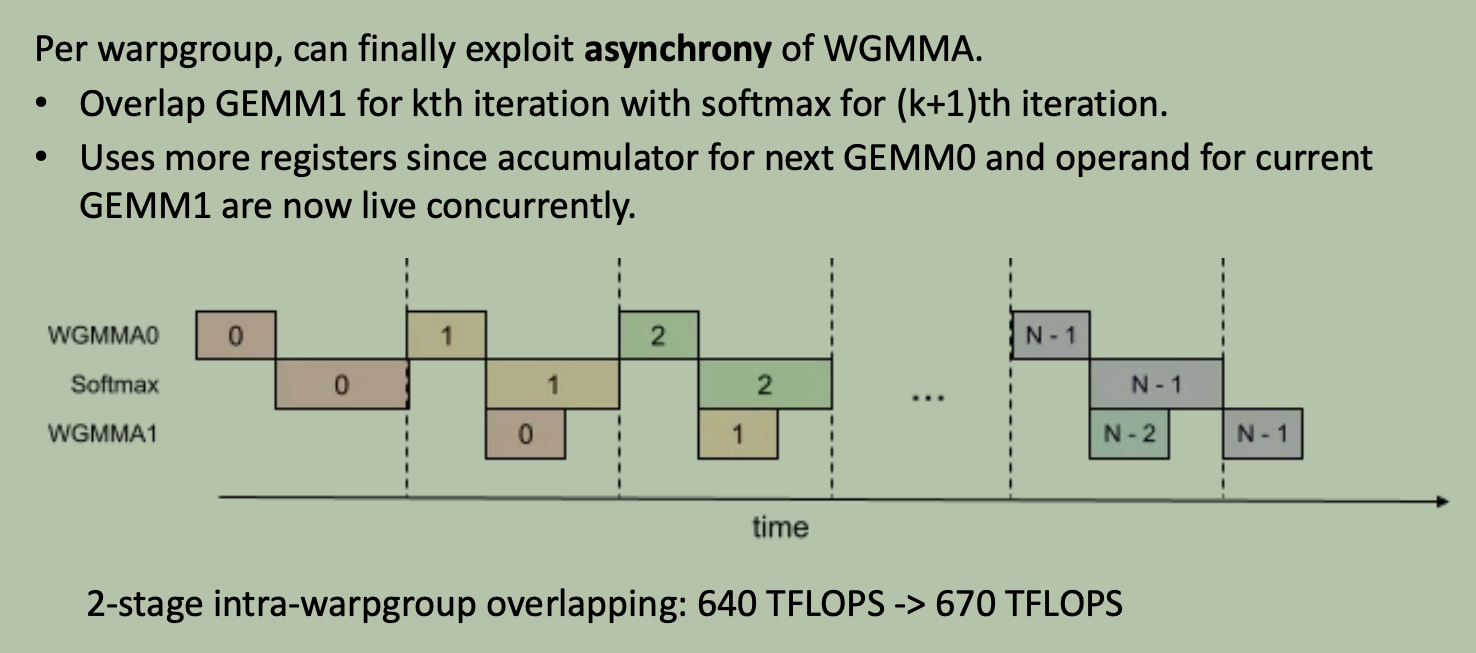
Intra-warpgroup Overlapping(WarpGroup 内部 2 阶段重叠):在单个 WarpGroup 内部,利用 WGMMA 的异步特性,将第 \(k\) 次迭代的 GEMM1 (\(P \cdot V\)) 与第 \((k+1)\) 次迭代的 Softmax 进行重叠,进一步将性能从 640 TFLOPS 提升至 670 TFLOPS。
4.1.3 Low-precision – FP8
- FP8 性能与离群值(Outliers)困境:FP8 Tensor Cores 将 WGMMA 吞吐翻倍,但低精度更容易受到输入数据中离群值(Outliers)影响导致量化失真。
- Hadamard 正交变换解法:利用正交矩阵 \(J\) 满足 \(J J^T = I\) 的数学性质,将 Query 和 Key 乘以随机正交矩阵 \(J\),使得 \(S = Q K^T = (Q J)(K J)^T\) 在数学上依然成立。这一变换将集中在个别维度的“离群值”均匀分散(Spread out),在保留 FP8 高吞吐的同时,将量化误差(RMSE)降低了 2.6 倍(从 \(2.4 \times 10^{-2}\) 降至 \(9.1 \times 10^{-3}\))。
4.1.4 Persistent Kernels: Hiding Prologue & Epilogue
- 动机:由于 Tensor Core 计算极快,Kernel 启动/结束的前导(Prologue)与尾部写回(Epilogue)延迟已不可忽略。
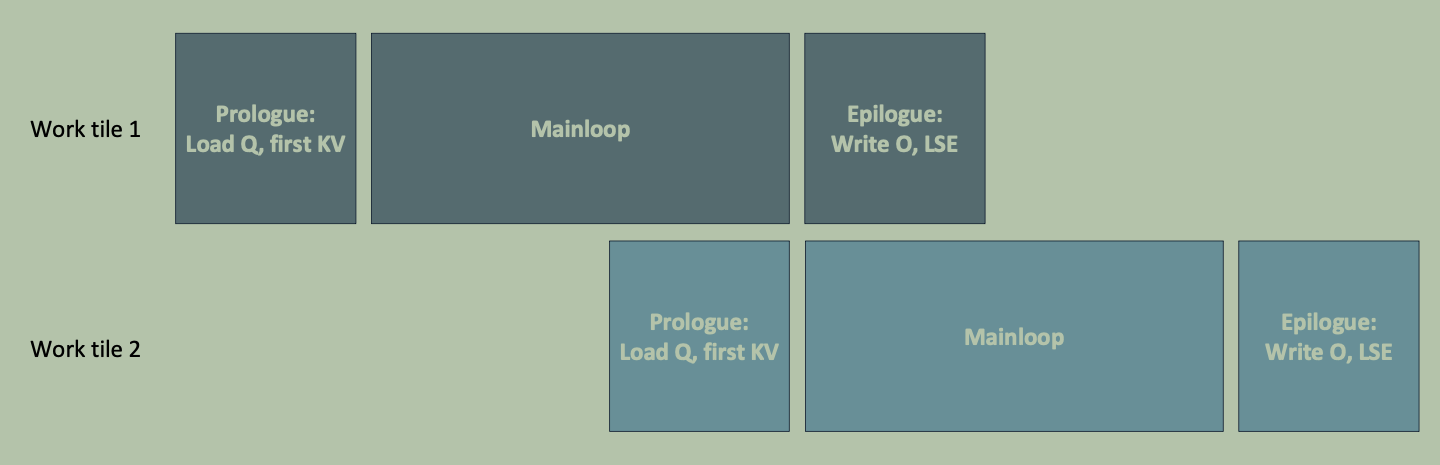
- 解法:在 GPU 上发射固定数量的 CTA(匹配 SM 数量),使其在多个 Task Tile 之间“持久化”连续运行;同时利用 TMA 异步写回,将上一 Tile 的尾部写回、下一 Tile 的前导加载与当前 Tile 的 Mainloop 计算重叠,性能从 670 TFLOPS 提升至 700 TFLOPS。
示意图如下:
4.1.5 Load Balancing: Causal Attention
- 问题:在 Casual Mask 下,由于三角矩阵的遮蔽特性,不同 Tile 的计算量差异极大,容易导致 SM 线程块负载倾斜。
- 解法:引入经典调度理论中的 LPT(Longest-Processing-Time-First,最长优先)调度策略,优先安排计算时间最长的 Tile 进行计算,使多个 SM 间的负载得到均衡(优化为),将 Causal Attention 性能从 670 TFLOPS 提升至 730 TFLOPS。
- 注意点:Take care to not spill L2 cache (using L2 swizzling)。
- L2 Spill 的触发原因: 为了解决因果掩码(Causal Mask)带来的 SM 负载不均问题,FlashAttention-3 引入了 LPT 调度——按计算量从长到短去打乱并分派 Tile。 但如果盲目为了负载均衡而过度打乱调度顺序,导致各个 SM 在同一时间段内读取的 KV 块跨度极大、超出了 L2 Cache 的容量,已缓存的 KV 数据就会被强制驱逐(Cache Eviction / Spill)。下一次其他 SM 需要这个 KV 块时,就必须重新花费漫长的时间从极慢的 HBM 中读取,导致性能下降。
- 解决方法:
- 核心思想:重新组织 CUDA 网格(Grid)中 CTA(Thread Block)对 Tile 的访问与映射顺序(如采用 2D Block Swizzling 或坐标 z-curve 变换)。
- 物理效果:
- 提升时间局部性:让物理上同时运行的多个 SM 优先处理共享同一批 KV 块的 Query Tiles。
- 锁定 L2 缓存命中:第一个 SM 从 HBM 将 KV 块加载到 L2 Cache 后,后续并发的 SM 都能直接在 L2 Cache 中高命中率读取,彻底避免了数据反复从 HBM 重新加载。
假设有:2 batches, 3 workers (SMs),如果朴素的按顺序指定每个 SM 完成后处理下一行,则需要等待最后的一个 SM 处理完一行才可以结束,示意图如下:
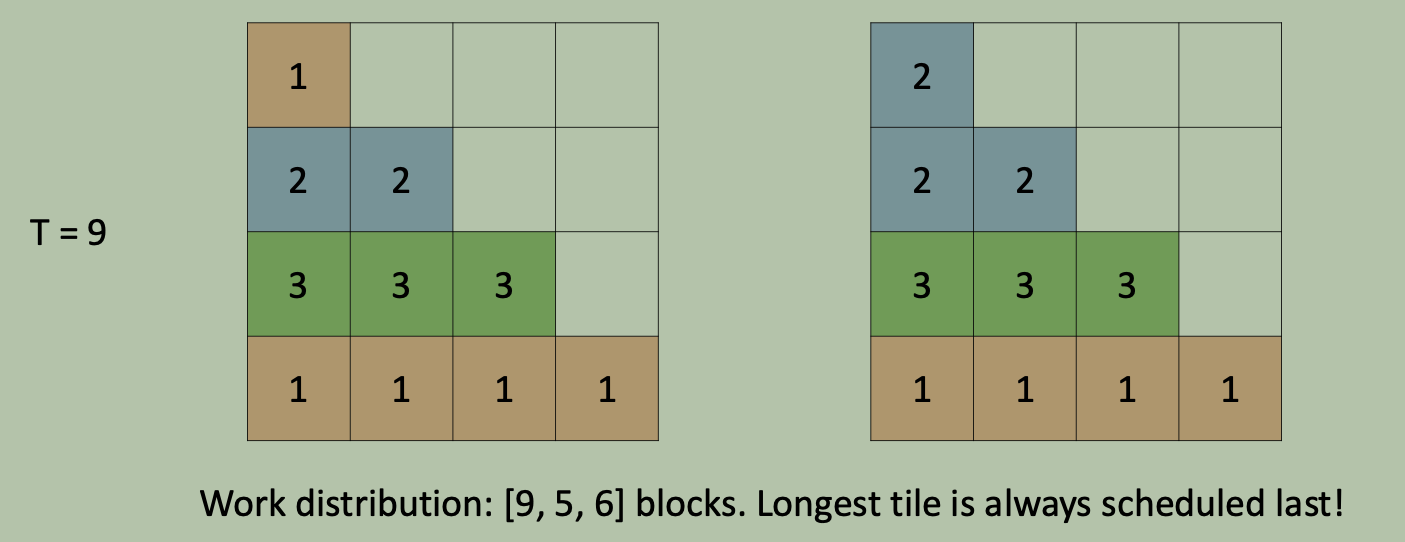
- 三个 SM 分别处理了 9,5,6 个 blocks,由于复杂不均衡需要等待第一个 block 完成,一共需要 9 个单位耗时。
若按照:最长处理时间优先方式(Assign work to workers using longest-processing-time-first)进行任务调度,则可以节省处理实现,示意图如下:
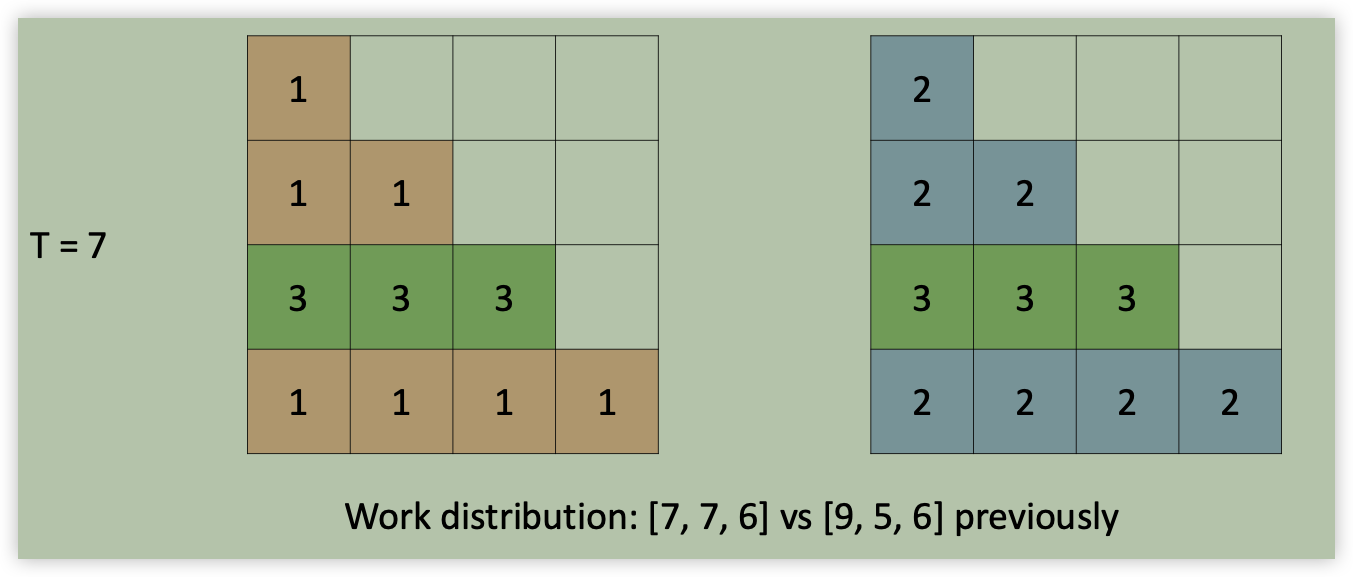
- 首先将最底下的行分配给 SM 执行,按照处理时间优先方式进行调度。
- 最终耗时为 7 个单位,降低了整体执行时间。
4.1.6 Evaluation
- BF16 模式:达到了 730–840 TFLOPS(相比 FlashAttention-2 提升 1.6–2.2 倍,性能非常接近纯 GEMM 矩阵乘法的理论极限)。
- FP8 模式:计算吞吐量高达 1.3 PFLOPS (1300 TFLOPS)。
4.2 FlashAttention 4: Algo-Kernel Co-design for Asymmetric Hardware Scaling
- 问题:新一代 Blackwell GPU 的硬件特性变化不对称性
- Tensor Core 算力翻倍:B200 的 BF16 Tensor Core 峰值吞吐从 H100 的 4096 ops/SM/clock 涨至 8192 ops/SM/clock(翻倍)。
- SFU 与 SRAM 带宽原地踏步:
- 指数计算单元(SFU / Exponential):H100 和 B200 均维持在 16 ops/SM/clock。
- Shared Memory (SRAM) 带宽:H100 和 B200 均维持在 128 bytes/SM/clock。
- 导致的全新硬件瓶颈:
- 前向传播瓶颈:由于 Tensor Core 变快了 2
倍,而指数计算单元
exp速度没变,前向传播的瓶颈转移到了 指数单元 SFU 上。 - 反向传播瓶颈:反向传播需要频繁在片上搬运梯度和中间激活值,受限于未增长的 Shared Memory 显存带宽。
- 前向传播瓶颈:由于 Tensor Core 变快了 2
倍,而指数计算单元
4.2.1 Forward Pass: Redesigned Algorithm to Go Beyond Hardware Limits
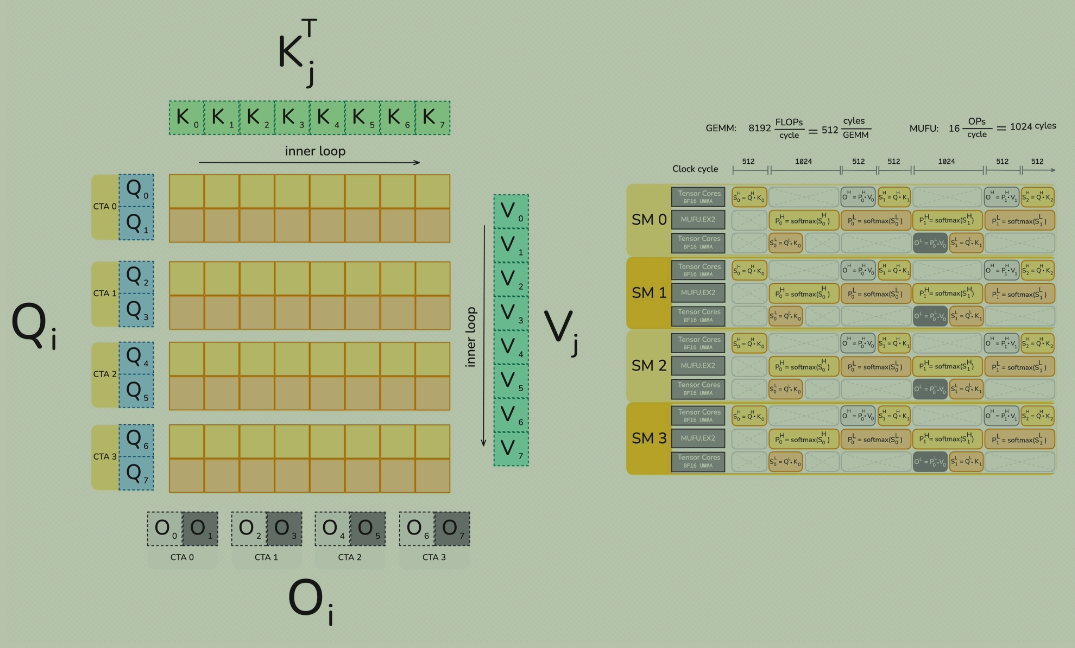
- Query Tile 乒乓流水线(Pingpong Pipeline of Query Tiles):在多个 Query 块之间重叠 GEMM 与 Softmax 指数计算,打满计算流水线。
- 切比雪夫多项式拟合指数(Exp Emulation with Chebyshev
Polynomials):
- 硬件上的 SFU
exp指令极其昂贵且吞吐极低。 - FA-4 提出使用切比雪夫多项式(Chebyshev Polynomials)在 Tensor Core 上直接模拟/拟合指数计算,将指数计算转化为 Tensor Core 擅长的乘加运算,避开了 SFU 的吞吐限制。
- 硬件上的 SFU
- 在线 Softmax 新变体(New Variant of Online
Softmax):
- 通过优化在线 Softmax 的维护逻辑,跳过了 90% 的 Rescaling 重缩放计算开销,大幅降低了指数修正动作的频率。
4.2.2 Backward Pass: New 2CTA MMA Instructions to Reduce Smem Bandwidth
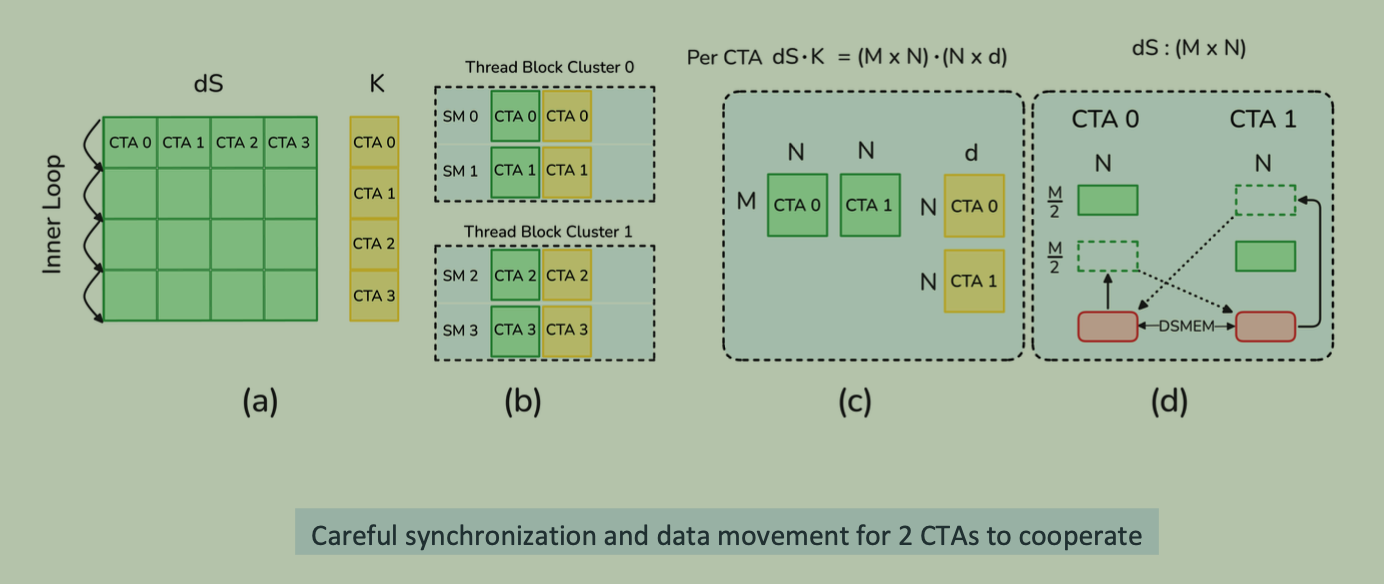
- 引入 2-CTA MMA 协作指令:在 Blackwell 架构中,利用 Thread Block Cluster,让 2 个 SM(2 个 CTA) 通过分布式共享内存(DSMEM)协作完成同一个矩阵乘法(如 \(dS \cdot K\))。
- 物理效果:通过 2 个 CTA 共享数据与精心设计的同步逻辑,减少了重复的数据加载,降低了 Shared Memory 显存 traffic 带宽开销。
4.2.3 Evaluation
- 硬件算力达标:
- 前向传播:在 B200 上达到了 1576 ~ 1600 TFLOPS,使 Attention 算子速度再次追平了纯 GEMM 矩阵乘法的理论极限。
- 反向传播:达到了 1420 TFLOPS,相较于 FA-2 基线实现了 4 倍的物理加速。
- Cute-DSL 编写与 FlexAttention 集成:
- FA-4 内核采用 Cute-DSL 进行编写。
- 提炼出的抽象(如 Block-Sparse、Masking)被全面融合进 PyTorch 的 FlexAttention 中,为 Alibi、Softcap 等多样化注意力变体带来了 2.7 ~ 3.0 倍 的全面加速。
5. Optimize Attention for Inference
5.1 Motivation
在 LLM 的 Decoding 阶段,计算模式与训练/Prefill 阶段有本质的不同:
- Query 长度极短:单次生成时, Query 的序列长度通常只有 1 个 Token(或几个 Token,如 1~4)。
- Context/KV 长度极长:需要关注历史积累的超长 KV Cache(如 128k 上下文)。
- 硬件挑战:在常规前向传播中,线程块(Thread Block)是按 Query 维度划分的。如果 Query 极短,GPU 就无法分发出足够多的物理计算任务来打满所有的 SM,导致算力被严重浪费,变成极端的显存带宽限制型(Memory-Bound)任务。
5.2 Solution
- Split-KV / Flash-Decoding(沿 KV 序列维度切分并行)
- 原理:既然 Query 维度太短不够 SM 分配,那就沿着 KV 序列长度方向进行切分(Split along KV sequence length)。
- 机制:将长的 KV Cache 切分成多个独立的子块(例如 Split 1/5 到 5/5)。让 GPU 上不同的 SM 并行计算各自局部 KV 块的注意力输出和归一化统计量(\(m, l\)),最后在全局做一个极轻量的归一化规约合并。
- 效果:极大增加了可并行的 Block 数量,把庞大的 KV 读取工作量平摊给 GPU 上的所有 SM,彻底打满显存带宽。
- GQA Packing(多 Query Head 打包填满硬件 Tile)
- 原理:在 Hopper 架构上,硬件矩阵乘法指令(WGMMA)的 Tile 在 \(M\) 维度(Query 维)上的固定宽度是 64。如果 Query 很短(比如只有 4 个 Token),这 64 宽度的 Tile 大部分位置都是空的,造成了严重的硬件计算浪费(Tile 无法填满)。
- FA-2 的局限:FlashAttention-2 仅针对单 Token(Query length = 1)的简单 Reshape 情况做了打包。
- FA-3 的扩展:在 Grouped-Query Attention (GQA) 或 Multi-Query Attention (MQA) 中,多个 Query Head 共享同一个 KV Head。FlashAttention-3 实现了将属于同一个 KV Head 的多个 Query Head(例如 16 个 Query Head \(\times\) 4 个 Query Token = 64)打包组装成一个完整的 \(64 \times 128\) 硬件 Tile,拓展到了任意 Query 长度下的通用打包。
- 效果:消除了硬件 Tile 的 Padding 浪费,显著提升了 Tensor Core 的吞吐效率。
6. Conclusion
- Fast and accurate attention optimized for modern hardware
- Key algorithmic ideas: asynchrony,
low-precision
- Persistent kernels with LPT scheduling for causal attention
- For inference: Split KV (Flash-Decoding) and GQA packing
- Upshot: faster training, better models with longer sequences
- Code: