LLM Systems 23: Design of Efficient LLM Inference Server
1. Overview of LLM Inference Server
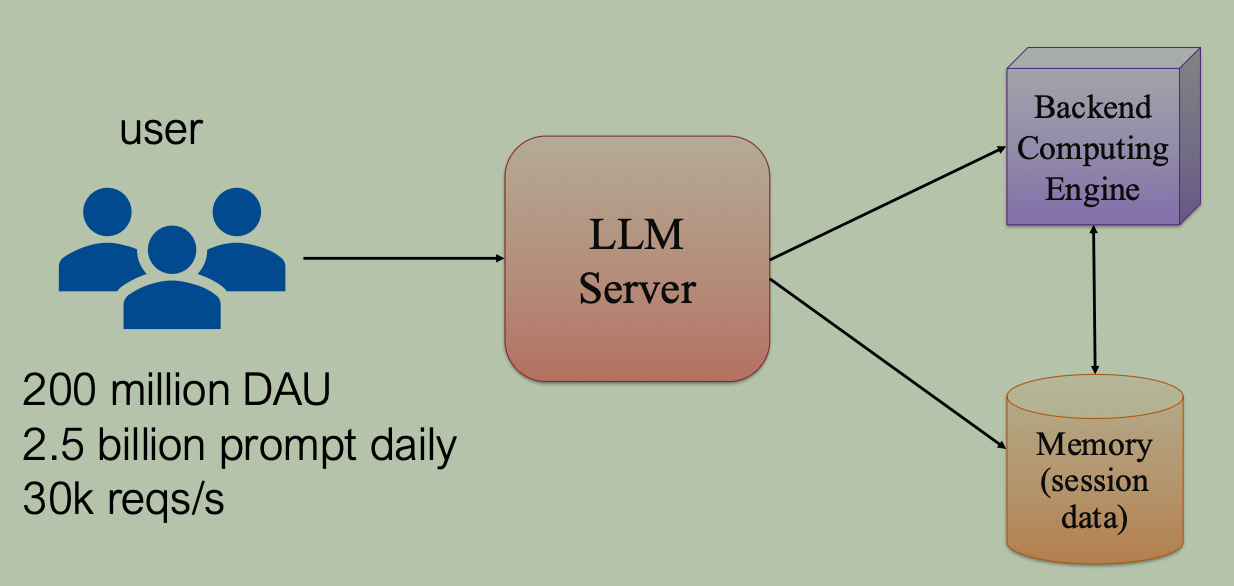
- LLM Serving 系统总体架构如上图所示
- Web Server 接收用户请求,并发送给后端推理引擎;
- 推理引擎进行模型推理 & KV Cache 存储与管理等。
LLM Serving Pattern
- 单轮多用户生成 (Multi-user Single Round Generation):不同用户独立提交请求(Prompt 1 → Answer 1, Prompt 2 → Answer 2)。核心观察是不同用户可能提交相同的 Prompt 或包含大量重复前缀(如通用的 System Prompt)。
- 多轮对话 (Multi-round Chat):同一用户与模型进行多轮交互(Prompt 1 → Answer 1 → Prompt 2 → Answer 2 ...)。
- 多生成 / 少样本示例 (Multi-Generation / In-context Examples):同一 Prompt 需生成多个不同回答,或带有 In-context Examples 的复杂 Prompt。
Design Goals of Efficient LLM Server
- 支持多用户并发会话:在海量并发下高效维持会话状态。
- 应对复杂的请求特征:高效处理请求序列长度差异悬殊(Varying sequence generation lengths)以及不同请求具备公共前缀(Common prompt prefix)的情况。
- 优化吞吐量与延迟:在最大化系统吞吐量(Throughput)与降低用户延迟(Latency)之间取得平衡。
- TTFT (Time-To-First-Token):首 Token 延迟,主要由 Prefill 阶段的计算量决定。
- TPOT (Time-Per-Output-Token) / ITL (Inter-Token Latency):逐 Token 生成延迟,主要受 Decode 阶段的显存带宽限制。
- 利用异构设备:CPU/GPU。
- 代表性系统实现:如 ORCA、vLLM、SGLang 等。
2. LLM Request Scheduler
LLM Server Architecture
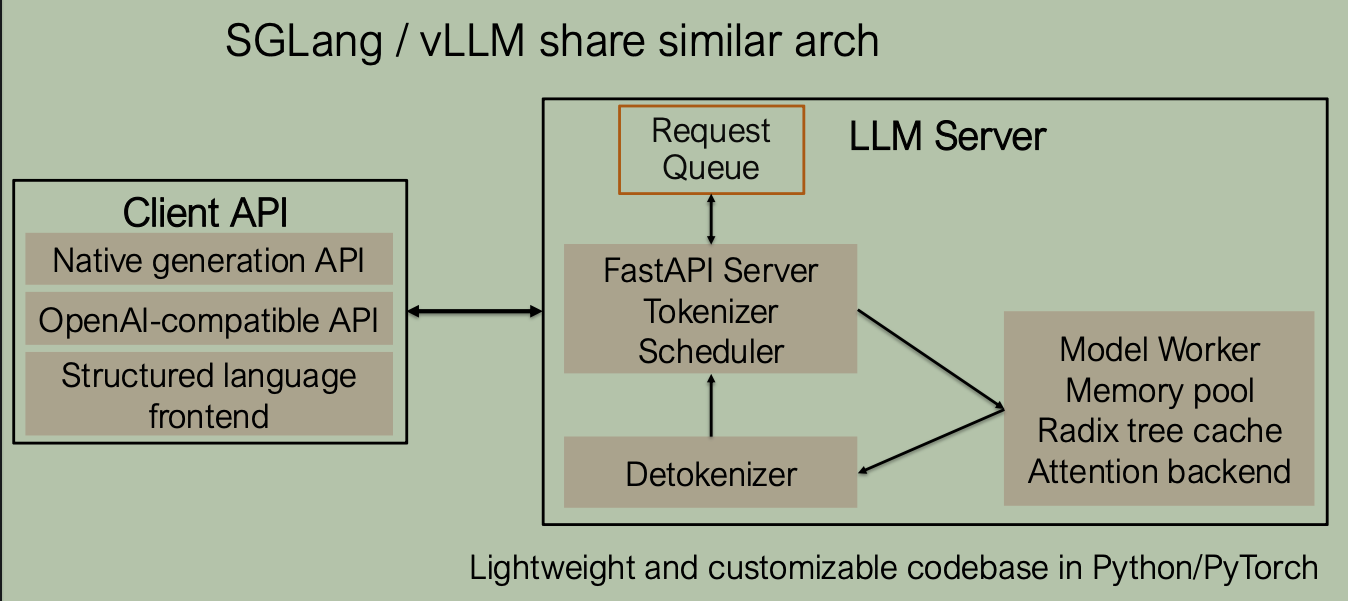
vLLM/SGLang 等推理系统遵从相似的整体架构:
- Client API 接入层:提供 Native API、OpenAI 兼容接口以及结构化语言前端(Structured language frontend)。
- FastAPI Server & 调度控制层:包含 FastAPI 框架接收 HTTP 请求、Tokenizer 将文本转换为 Token 序列、Request Queue 请求队列、Scheduler 调度器以及 Detokenizer 输出解码。
- Model Worker 计算层:运行在 GPU 上的核心计算引擎,包含 Memory Pool(显存池)、Radix Tree Cache(前缀树缓存)以及 Attention Backend(注意力计算后端)。整个架构基于 Python/PyTorch 构建,轻量且易于定制扩展。
LLM Request Scheduler
核心功能:
- 接收输入消息:处理客户端发来的请求(
recv_requests)。 - 流式输出模型结果:处理 Model Worker
返回的计算结果并写回客户端(
process_batch_result)。 - 停止条件检查:判定请求是否生成结束(如遇到
EOS或达到最大 Token 数)。 - 请求重排序与前缀匹配:维护缓存树并重新挑选优先级最高的请求。
- 显存分配与 Batch 构建:为当前 Step 及下一个 Batch 分配 GPU 显存。
伪代码描述:
1 | |
SGLang schedule 主循环代码:
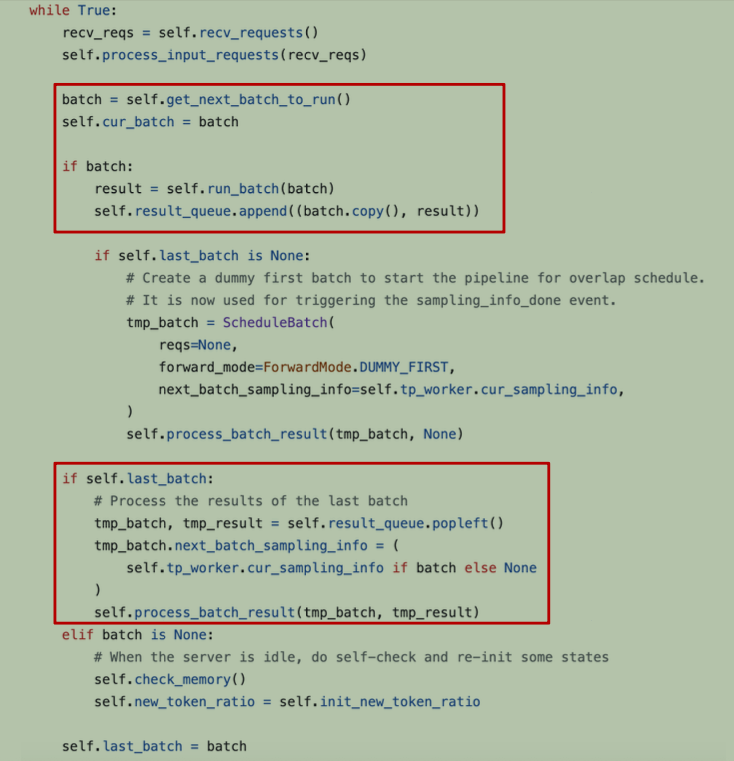
整体流程如下:
- 接收 requests 并进行预处理。
- 获取要运行的 batch。
- 将当前 batch 发射给 GPU Worker 计算(非阻塞/异步)。
- 将当前 batch 及其异步结果句柄推入结果双端队列
result_queue。 - 处理【上一个批次】(last_batch) 的 GPU 计算结果。
- 当服务器完全空闲(没有待处理 Batch)时,做内存自检与状态重置。
- 状态迭代:将当前 batch 记录为下一次循环的 last_batch。
- 核心技巧:
- 当前循环刚发射给 GPU 的
batch不立刻读取结果,而是在当前 Step 异步让 GPU 算着,同时去解析处理上一次迭代( last_batch)的 GPU 输出结果,从而实现了 CPU 与 GPU 的 overlap。
- 当前循环刚发射给 GPU 的
3. Scheduler with Continuous Batching
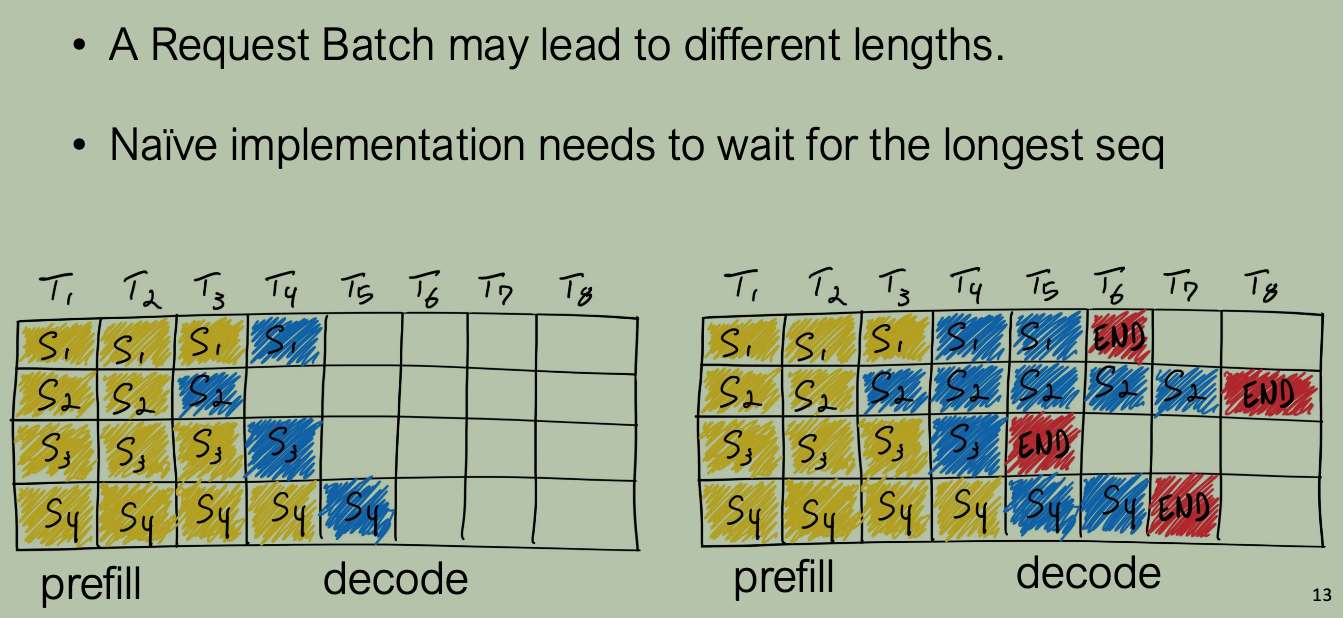
- 朴素调度实现存在的问题:
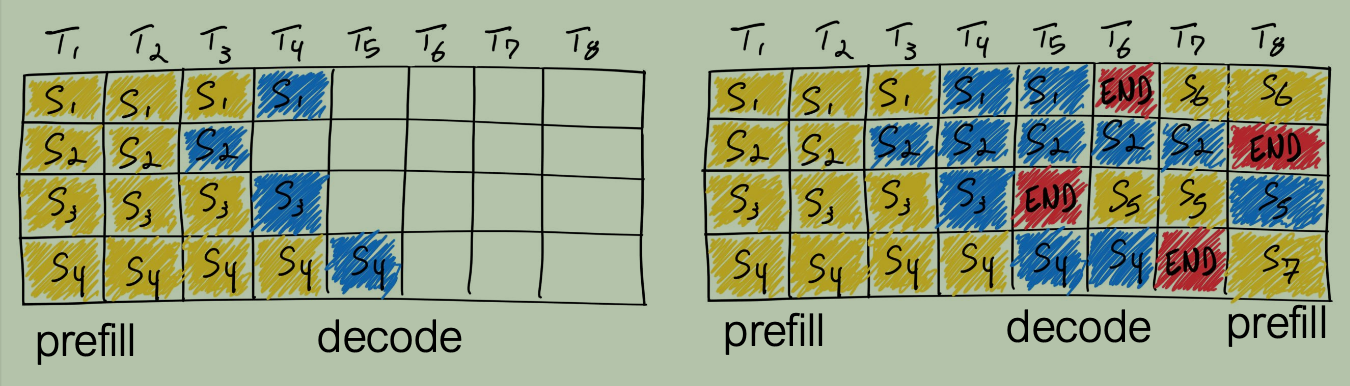
- 一个 Batch 中的不同请求生成长度参差不齐。朴素实现必须等待 Batch 中最长的序列生成完毕,导致已结束请求的通道出现 GPU 算力空转。
- Continuous Batching
- 由 ORCA 论文(OSDI 2022)提出,在 Token
迭代级别(Iteration-level) 进行调度。在每一个 Token 生成 Step
中,只要有请求生成完毕(遇到
END),立即从等待队列中注入新的 Prefill 请求或展开新请求。示意图如下:
- 由 ORCA 论文(OSDI 2022)提出,在 Token
迭代级别(Iteration-level) 进行调度。在每一个 Token 生成 Step
中,只要有请求生成完毕(遇到
Selective Batching
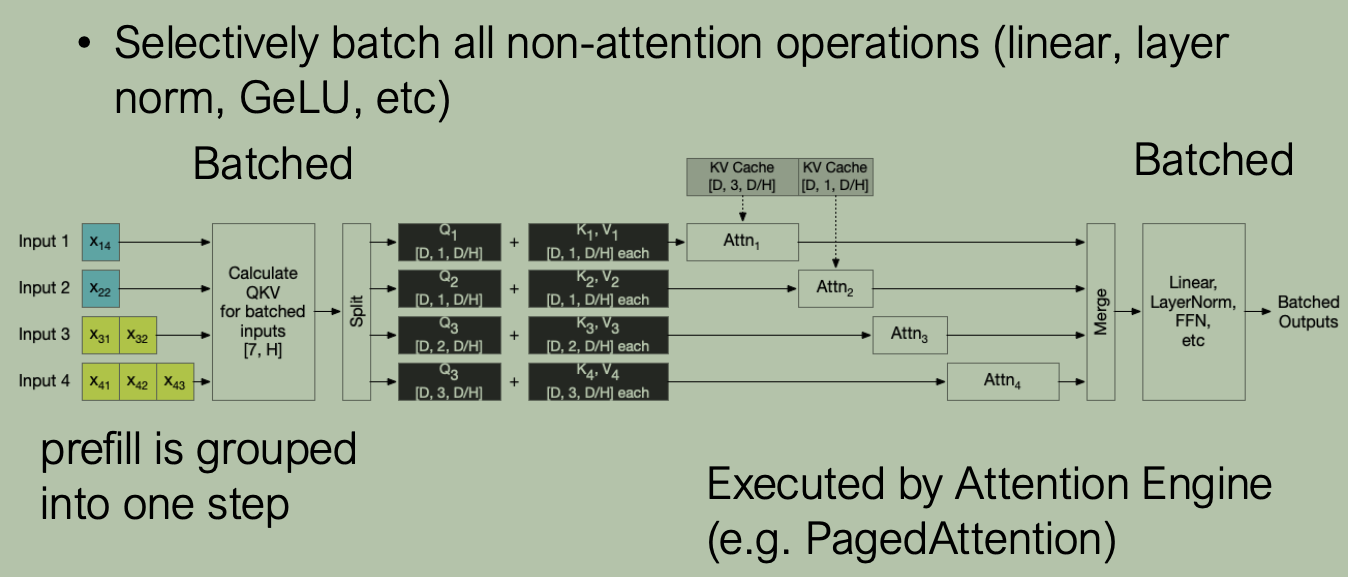
- 将所有非 Attention 操作(如 Linear 线性层、LayerNorm、GeLU)统一拼成一个大 Batch 计算(Padding-free 拼合)。如上图左侧所示。
- 将Attention 操作剥离出来,单独交由专门的 Attention 引擎(如 PagedAttention)基于各自的 KV Cache 进行计算。如上图右侧所示。
Inside Scheduler of SGLang
- get_next_batch_to_run():
- Prefill 转 Decode:若已有 Prefill 结束,将其移动至运行中的 Decode Batch。
- 加入新 Prefill:通过
get_new_batch_prefill结合等待队列优先级与剩余 Batch 容量加入新请求。 - 继续 Decode:若无新 Prefill,调用
update_running_batch()继续迭代 Decode。
- check_decode_mem
(显存检查与抢占机制):
- 若 GPU 显存足够:执行
prepare_for_decode,调低new_token_ratio。 - 若显存溢出:触发
batch.retract_decode,调高new_token_ratio,并将被撤回的请求重新放回prefill_waiting_list。
- 若 GPU 显存足够:执行
- process_batch_result:检查请求是否完成;完成时释放其 KV Cache(仅减少 RadixTree 引用计数,并不物理清空显存)。
4. KV Cache Management with RadixAttention
KV Cache Management
- 为何传统 NN/RNN 不需要,而 Transformer 极度依赖:标准神经网络仅保存当前层输出,RNN 维持隐藏状态;但 Transformer 自回归生成每个新 Token 时,都需要前向依赖之前所有 Token 在每一层的 Key 和 Value。
- 显存膨胀定量计算:以 LLaMA3-70B(80 层 Transformer、隐藏维度 8192)为例,在 FP32 精度下,单 Token 产生的 KV Cache 就需 2.5MB 显存。对于 8k 的上下文长度,仅一条请求的 KV Cache 就高达 20GB,极易导致 GPU 显存 OOM。
Managing KV Cache with RadixAttention
- CPU-GPU 双层架构:
- RadixTree(前缀树)维护在 CPU 内存中。
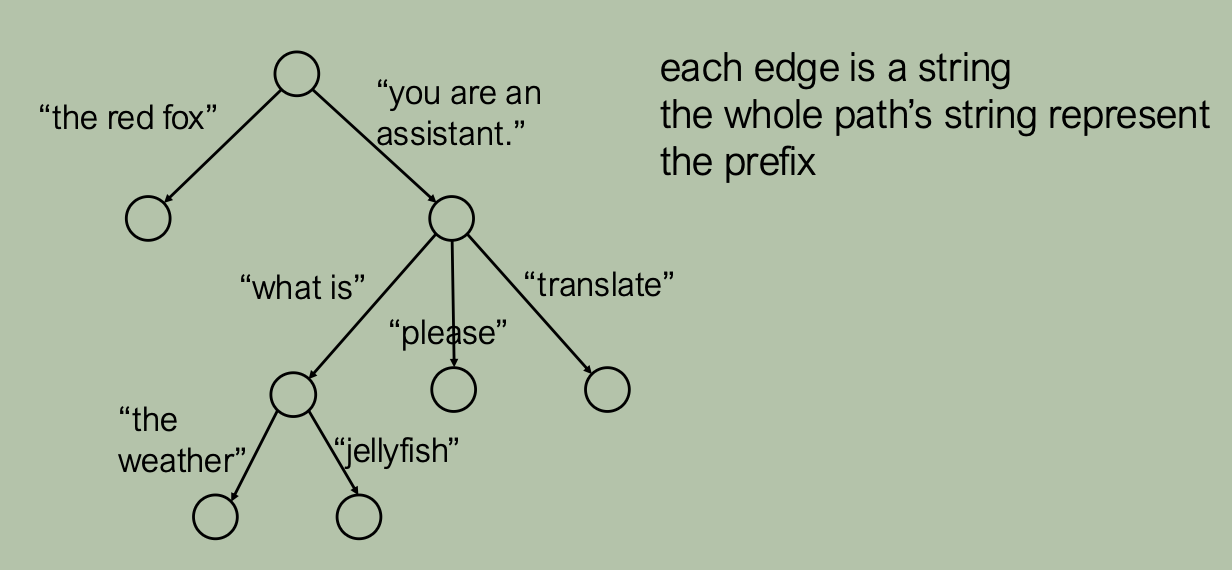
- 树的边(Edge):代表连续的 Token 字符串/序列。
- 树的节点(Node):存放指向 GPU 物理显存中对应 KV Cache 的内存指针。
- 路径前缀:从根节点到某一节点的完整路径字符串即代表该位置的前缀。
- 前缀快速检索(Lookup):新 Prompt 到达时,通过边匹配快速查找到树中的最长公共前缀,返回匹配的 Token 数量及对应的节点指针,省去已匹配部分的 Prefill 计算。
Radix Tree
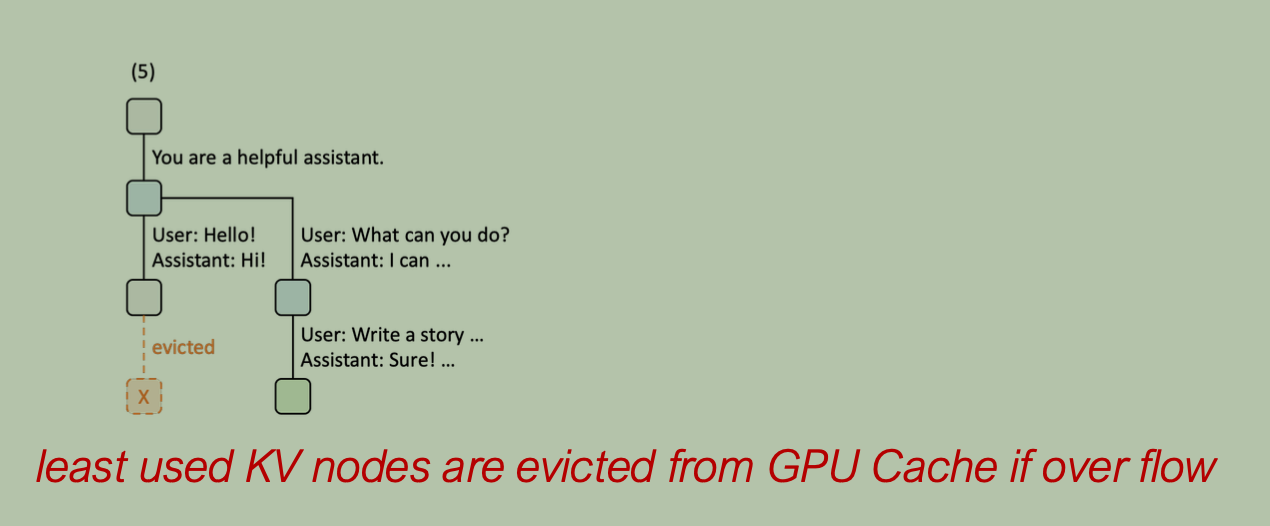
- 插入新请求 (Add KV):首轮对话生成后,将新的 Token 序列与对应的 KV 指针挂载为树节点。
- 多轮扩展 (Extend):同一会话的下一轮交互到来时,直接在原有回答节点下方追加新的子节点。
- 节点分裂 (Node Split):当新请求与现有节点仅匹配部分前缀时(例如共享 System Prompt 但后续 Prompt 不同),系统将原节点切断分裂为父节点(公共前缀)与两个独立子节点。
- 缓存淘汰 (Eviction):当 GPU
显存满载(Overflow)时,调度器基于 LRU / Least-Used
策略将最久未使用或访问频率最低的节点从 GPU
显存中释放(上图中以虚线
X标记),树结构同步剪枝。 - 少样本示例共享 (In-context Examples):包含多组 Question/Answer 示例的系统 Prompt 被挂载为高频父节点,下游多个不同的问答分支共同继承该节点,实现 0 重复 Prefill。
5. Cache-aware scheduling and load balancing
KV Cache-aware Scheduler with RadixAttention
- Motivation:在请求队列中,根据请求的前缀批评长度排序进行 request 调度,而不是简单的 FIFO,以提升 cache 命中率。
- 调度算法与伪代码 (
get_next_batch):- 前缀匹配:遍历等待队列中的每个请求
req,在 RadixTree 中检索其可复用的最长前缀长度req.prefix_length = match_prefil(req, radix_tree_cache)。 - 队列重排序:执行
waiting_queue.sort(),优先调度前缀匹配度更高(prefix_length 更长)的请求。 - 构建
Batch:在显存约束内(
can_run(req)),优先将这些高命中率的请求装入下一个 Prefill Batch 运行。
- 前缀匹配:遍历等待队列中的每个请求
Cache-aware Load Balancer
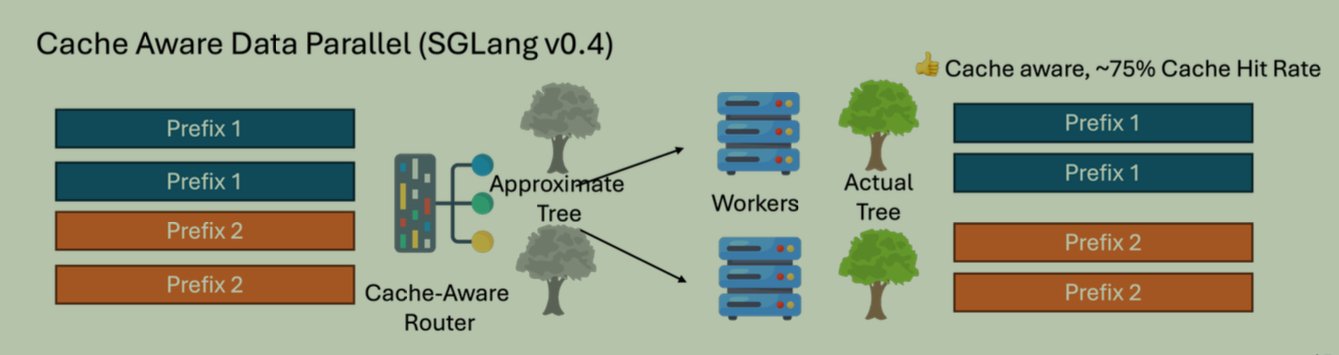
- 传统 Round-Robin(SGLang v0.3)的局限:
- 采用传统的轮询(Round-Robin Data Parallel)方式分发请求,无法感知各 Worker 节点的缓存状态。
- 结果:具有相同前缀的请求(如 Prefix 1、Prefix 2)被随机打散到不同的 Worker 节点上,导致集群全局缓存命中率极其低下(仅约 20%)。
- 缓存感知数据并行(SGLang v0.4 Cache-Aware Data
Parallel):
- 核心架构:在入口 Router 端维护各个 Worker 节点的“近似树(Approximate Tree)”,而各 Worker 节点维护各自实际的 RadixTree(Actual Tree)。
- 定向路由:Router 在分发请求前,基于 Approximate Tree 预测该请求在各个 Worker 上的 KV Cache 命中率,并将请求分配给匹配率最高的 Worker 节点。(KV Cache 命中率提升到 75%)
6. Zero-overhead scheduler and worker
CPU Overhead with Scheduler
Blocking Scheduler 与 Overlapped Scheduler 实现示意图如下所示:
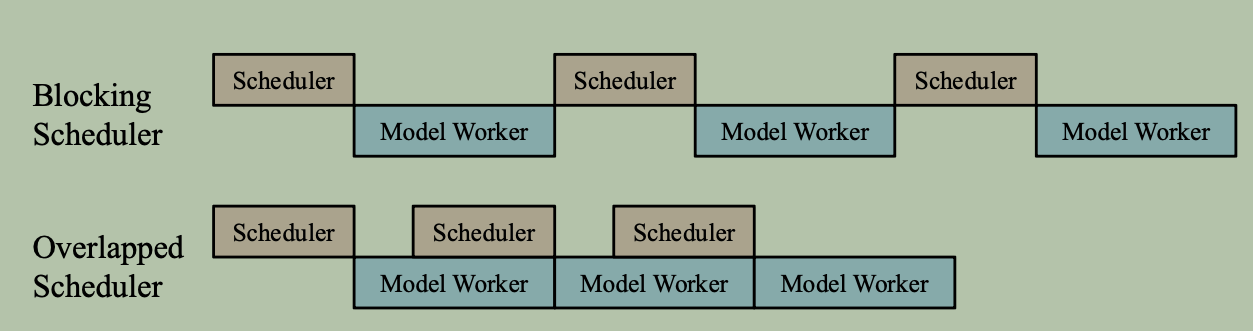
- Blocking Scheduler 存在的问题:
- CPU 与 GPU 串行执行,导致 GPU 存在大量空闲。
- Overlapped Scheduler:实现 GPU 与 CPU 同时运行,消除 GPU bubble。
- 延迟停止条件检查(Delaying Stop Condition Check):解除 CPU 必须“实时同步检查 EOS 终止符”的强依赖。
- 细粒度 CUDA 事件流管理(CUDA Events & Streams):利用 CUDA Stream 与 Event 实现 CPU-GPU 间的细粒度调度。
Full Execution Flow on SGLang
参考:
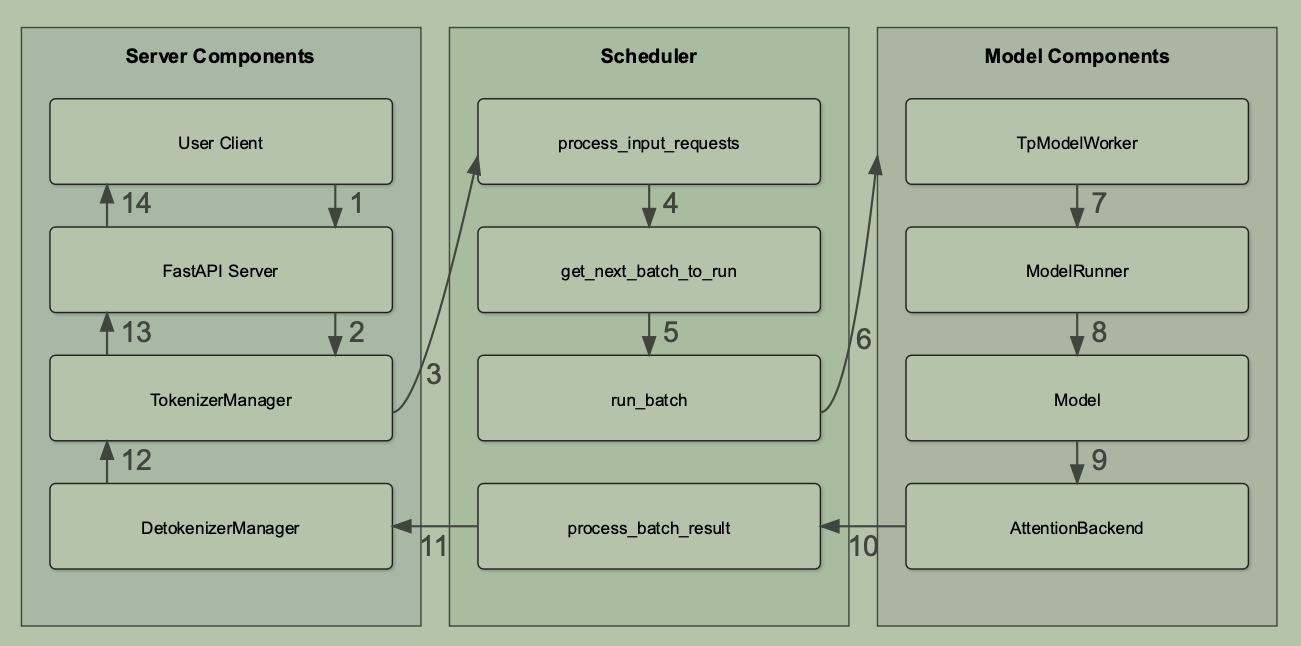
SGLang 请求的处理过程如下:
- 用户启动 Server ,初始化 FastAPI App、TokenizerManager、DetokenizerManager 和 Scheduler,每个组件运行各自的无限事件循环(infinite event loop)。
- 用户向 FastAPI Server 发送
/v1/chat/completions请求,Server 通过v1_chat_completionsendpoint 将请求转发到 TokenizerManager。 v1_chat_completions函数将请求转换为ChatCompletionRequest,再转换为GenerateReqInput,并调用 TokenizerManager 的generate_request方法。- TokenizerManager 对请求进行 tokenization,并以 Python
对象(
pyobj)形式将其转发给 Scheduler,同时调用 TokenizerManager 的_wait_one_response方法。 - Scheduler 在事件循环
event_loop_normal中处理请求:- Scheduler 通过
recv_requests接收请求,调用process_input_requests处理输入,通过handle_generate_request管理生成请求的逻辑,并将其加入waiting_queue。 - 从
waiting_queue中,Scheduler 使用get_next_batch_to_run为即将处理的请求创建ScheduleBatch。 - Scheduler 执行
run_batch函数,将ScheduleBatch转换为ModelWorkerBatch。 - Scheduler 调用 TpModelWorker 的
forward_batch_generation,等待logits_output和next_token_ids。 - TpModelWorker 初始化
ForwardBatch,将其转发至 ModelRunner,并等待logits_output。 - ModelRunner 处理
ForwardBatch,调用forward_extend执行模型的前向计算(forward pass)。 - 模型通过
AttentionBackend加速生成 logits,返回给 ModelRunner,进而返回给 TpModelWorker。 - TpModelWorker 从 ModelRunner 接收
logits_output,调用 ModelRunner 的sample方法生成next_token_ids,并将其发送回 Scheduler。 - Scheduler 通过
process_batch_result处理批次结果,使用tree_cache.cache_finished_req(req)缓存请求,并通过check_finished验证完成状态。对于未完成的请求,Scheduler 继续其事件循环,直到这个请求满足结束条件;对于已完成的请求,则转发到 Scheduler 的stream_output。 - 在
stream_output函数中,Scheduler 处理输出,将其包装成BatchTokenIDOut,并发送给 DetokenizerManager。
- Scheduler 通过
- DetokenizerManager 在其事件循环中接收
BatchTokenIDOut,处理后生成BatchStrOut并返回给 TokenizerManager。 - TokenizerManager 在其事件循环中接收结果,通过
handle_loop处理并更新内部状态,然后将响应返回给Server 。 - FastAPI Server 最后封装完成的响应并将其返回给用户。
Additional Features of LLM Server
- SpecForge (Speculative Decoding):用轻量级小模型 Draft 大批量生成 Candidate Tokens,大模型仅需 1 次 Forward 即可并行验证多个 Tokens,突破 Memory-bound 瓶颈。
- XGrammar (Efficient Constraint Decoding):在要求输出 JSON 或特定语法树的场景下,通过 CPU 端高效的 DFA / Trie Tree 提前过滤 Token 概率掩码(Logit Mask),且不卡顿 GPU 计算。
- DeepEP (Expert Parallelism):针对 DeepSeek 等 MoE 模型在多卡间频繁高并发的全互连(All-to-All)通信开销专门优化的 GPU 通信库。
- MLA (Multi-head Latent Attention):DeepSeek 提出的低秩 Key-Value 联合压缩机制,将 KV Cache 显存压缩一个数量级。
7. Conclusion
- Basic LLM Request Scheduler
- Continuous Batching
- handling requests with varying lengths
- KV Cache Management with RadixAttention
- using radix tree to maintain KVs based on prompt prefix
- Cache-aware scheduling and load balancing
- Reducing overhead by overlap scheduling and worker compute
LLM Systems 23: Design of Efficient LLM Inference Server
https://arcsin2.cloud/posts/2026/11/3800657141/